本文へ移動
AI NEWS JOURNAL
FOLLOW THE THREAD

AI コーディング

テーマに沿って、新しい事実とその後の進展を追います。

公開日時順

今年の1024は、おそらく最後のプログラマーの日かもしれません

著者|Wildcard 編集|靖宇 今日は一日中、X 上で「1024 プログラマーの日おめでとう。今年は最後のプログラマーの日になるのだろうか」という議論が繰り返されていました。しかもこの日はちょうど土曜日でした。微博では「今年のプログラマーの日は休日付き」という話題が広がり、投稿には「AI ツールが繰り返しのコーディングを肩代わりしてくれたおかげで、プログラマーも緊急な要件に邪魔されずに祝日を過ごせるようになった」と添えられていました。 影石は5年連続で優秀なプログラマーにゴールドキーボードカバーを贈っており、今年は新たに「F5」キーを加え、絶えず刷新・進化を重ねるという意味を込めました。授賞式の場で、ある若手社員が冗談めかしてこう言いました。「今年のゴールドキーボードカバーは、AI に渡すべきですね」。 ある企業の祝日に関する投稿はさらに率直で、「今年のプログラマーの日、私たちは採用枠を拡大しました。AI を指示して何かを作れる人も、立派なプログラマーです」と述べています。 一方、小紅書では、「古法プログラミング時代」というタグのもと、古い本を整理するプログラマーの姿が見られました。『図解 HTTP』は3冊で1枚、アルゴリズム関連の本は10元で売られていました。別の投稿のタイトルは「プログラマーの本は、多抓魚でも引き取ってくれない」というもので、最終的に売れた数冊のうち、最も高かったのはなんと『人月の神話』でした。 一つの祝日が、休日にされ、採用枠が拡大され、その“聖典”までが中古市場で値下げされる――そんな状況です。 祝日は通常、廃止によって消滅するわけではありません。むしろ、自分たちが誰であるかを確認するための存在意義を失ったときにこそ、消えていくのです。この言葉を理解するには、まずそもそもこの祝日がどのように生まれたのかを振り返る必要があります。 01 プログラマーの暗号から万人の祝日へ 1024 は、もともと公式な祝日ではありませんでした。その遠い親戚にあたるロシアの「第256日」プログラマーの日は、2009年に制定されました。中国に伝わる際、うるう年の影響で日付が変動しやすかったため、覚えやすい2の10乗に置き換えられました。そして2015年頃から、10月24日が慣例として「プログラマーの日」として定着しました。 これは業界内の人々だけが通じる一種の暗号のようなものでした。それに伴って育まれたのは、一連の自嘲的な表現です。2006年前後には『IT民工』がネット上で広まり、2009年から2012年にかけて「碼農(マノウ)」という呼称が急速に普及。さらに下には「碼奴」「碼畜」なども登場しました。こうした自嘲の前提には一定のハードルがあります。同年代より一段高い給与を受け取り、他人には理解しがたい仕事をこなすことで初めて、自らを「農民工」と呼ぶ自信が生まれるのです。2021年、中国人力資源社会保障部がソフトウェア従事者を「新世代の農民工」の統計対象に組み入れると、プログラマーたちは「マノウが本当に農民になった」とSNSでシェアし、その口調には怒りよりもむしろ喜びが感じられました。 その後、この暗号は業界の外へと持ち出されることになりました。2020年、CSDN
経緯と関連報道

KimiがK3.1 Proを発表、容量増加と価格引き下げでOpus 5.5に挑む

著者|宇航猿 編集|靖宇 10月23日午前、Kimi公式はXとビデオ番号で24秒の動画を公開した。映像にはレトロな雰囲気の古いパソコンが映り、画面にはKimi Codeが起動し、端末にはThree.jsのコードが一行ずつ表示され、複雑な3Dシーンが生成されていく様子が映っていた。目ざといネットユーザーはすぐに左上隅のモデル欄で答えを見つけた――「Model: Kimi K3.1」だ。 Kimi公式が公開したK3.1の事前告知動画|画像出典:X @Kimi_Moonshot 古い時代の機械で、今日最先端の3Dコードを実行する――このギャップこそが、月之暗面が伝えたいメッセージそのものだった。 それから十数時間後、10月24日零時を過ぎた直後、プログラマーの日に合わせてKimi K3.1 Proが正式にリリースされ、同時に速度が2〜3倍速いHighspeed版も同時に登場した。公式は、完全なモデルの重み付けデータを11月4日までに公開すると約束している。 前世代のK3が発表されてから、すでに3か月以上が経過していた。この3か月間、月之暗面が経験したことは、多くの企業が1年で経験する以上のものだった。 01 「量は増やしても価格は変えない」の0.1 まず、K3.1 Proとは何かを明確にしておこう。これはまったく新しいモデルではない。月之暗面は明確に、K3.1 ProはK3の後学習版であり、基盤は変わっていないと述べている――依然として総パラメータ2.8兆、活性化パラメータ1,040億の混合エキスパートアーキテクチャ、文脈ウィンドウは100万トークン、画像および動画入力にもネイティブに対応している。 変わったのは後学習の部分だ。公式によれば、「大幅に増強された後学習用の計算能力」を投入し、数百の下流分野で大規模な共同強化学習を実施したという。そのため、強化学習フレームワーク、サンドボックスインフラ、長文脈推論といった基盤技術を一から再構築したのだ。つまり、同じ脳が、仕事のやり方を改めて“教え直された”ということになる。 その効果はランキングで明らかだ。プログラミングAIを評価するTerminal-Bench 4.0において、K3.1 Proは65.7%を獲得し、GPT-6 Astraの58.2%やClaude Opusの66.4%をわずか1ポイント弱下回る結果となった。前世代のK3は

経緯と関連報道

清華大学と香港中文大学が共同でAKVをオープンソース化:LLMエージェント向けのKVキャッシュエンジニアリングサービスシステム

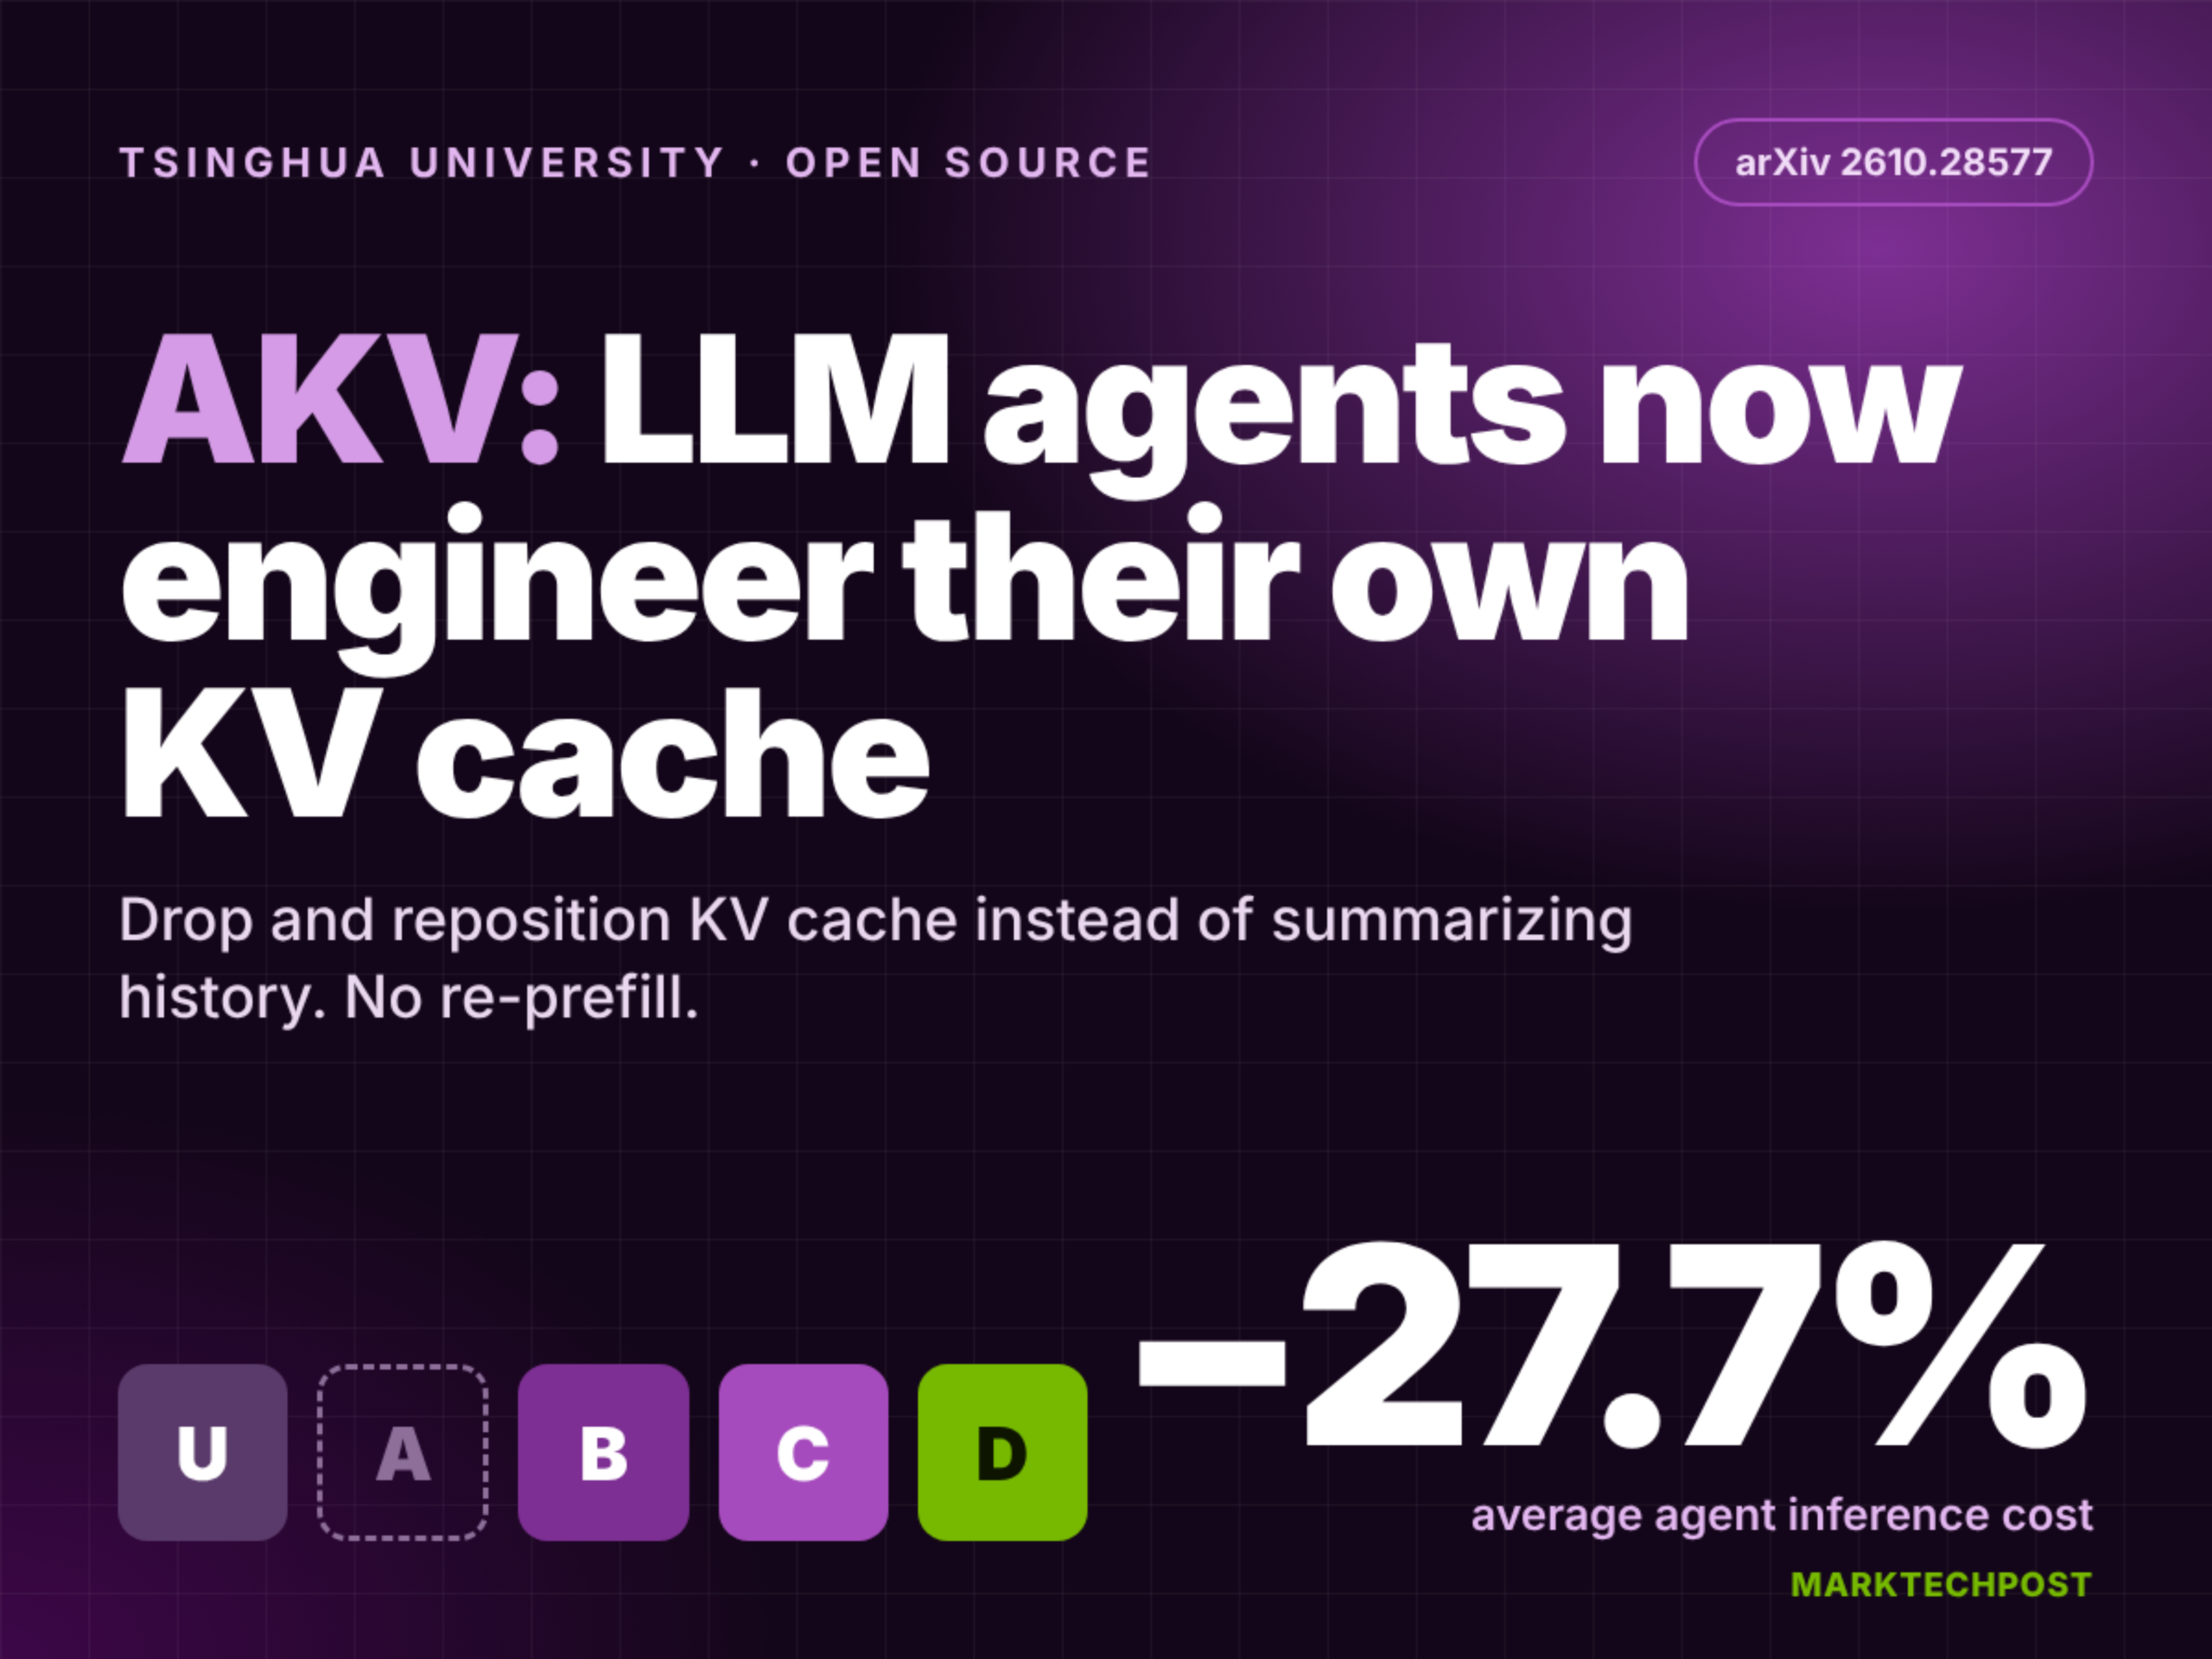
清華大学と香港中文大学の研究者らは、2026年10月26日、SGLangを基盤とし、大規模言語モデル(LLM)エージェント向けに設計されたKVキャッシュ用のエンジニアリングサーバーであるAKVをオープンソース化しました。このシステムは、従来のテキスト履歴の要約ではなく、エージェントが自らKVキャッシュを積極的に破棄・再配置することで、4つのエージェントベンチマークにおいて推論コストを平均27.7%削減し、タスクの平均スコアを1.7ポイント向上させました。コードはApache-2.0ライセンスのもとで公開されており、現在はQwen、GPT-OSS-120B、MiniMax-M2.7などのモデルをサポートしています。

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

注目する理由:この成果は、LLMエージェントによる効率的な推論の新たなパラダイムを示しています。テキストの切り捨てや要約に依存する「コンテキストエンジニアリング」とは異なり、AKVはKVキャッシュ状態を直接操作することで、重複したプリフィルを回避し、長距離間の相互作用におけるKV負荷を大幅に軽減します。実測では、高並行負荷下でP95遅延が229.9秒から30.6秒へと短縮され、明確な工学的価値と再現性を備えています。情報源はMarkTechPostが公開した権威ある技術レポートであり、公開日時(2026-10-26T07:56:45Z)は現在時刻と一致しており、最新の公表進展です。

経緯と関連報道

マルチエージェントLLMシステムにおけるコミュニケーションの失敗の理解

arXiv:2610.32060v1 発表タイプ:新規 要旨:マルチエージェントLLMシステムは、議論や証拠の共有、相互修正を通じて推論能力の向上を図るが、相互作用によっては最終的な精度だけでは説明できないような失敗が生じることもある。エージェントは早期に収束してしまったり、異論を無視したり、正しい少数派の解答を抑圧したり、ラウンド間で誤ったフレーミングを維持したりする場合がある。本研究では、医療QA、コーディング、金融、多段階推論、倫理、そして具現化されたテキストタスクにおいて観察された3,211件のマルチラウンド失敗トラジェクトリーに基づき、コルパスに根ざしたコミュニケーション失敗の分類体系を提示する。この分類体系を用いて、データセットおよびシステム設計ごとの失敗分布、ラウンドレベルでのエラー動態、回復の難易度、多数派への移行、少数派信号の抑制、さらには自己報告された信頼度などを分析する。その結果、

経緯と関連報道

LangChainが「企業向けエージェントフレームワーク」の5つの主要コンポーネントを発表

LangChainは2026年10月25日にブログを公開し、マーケティング、セールス、エンジニアリングの各チーム内でAIエージェント(GTM Agent、OpenSWE、Content Studio)を導入する際に蓄積された、以下の5つの一般的なアーキテクチャ原則を体系的に説明しました。すなわち、ネイティブな統合ワーク環境(Slack)、動的なアイデンティティモデル(OBO+固定資格情報)、二層メモリ機構(グローバル/ユーザー単位)、サンドボックス化されたコード実行、そして高い割合でのスケジュール実行(手動トリガーではない)です。すべてのエージェントはManaged Deep Agentsプラットフォームに基づいて構築されています。

注目する理由:この情報はLangChainの公式ブログから引用したもので、公開日時(2026-10-25T18:06:32.000Z)は現在のシステム時刻(2026-10-25T23:01:18.857Z)より前であり、内容はすでに実装された社内用インテリジェントエージェントの実践事例に焦点を当てています。詳細も具体的で(Slackのスレッド分離、GitHubアカウントの所有権帰属ロジック、NotionやTwitterの権限階層など)、未検証の予測や外部からの主張は含まれておらず、時宜性と事実性の要件を満たしています。

経緯と関連報道

スタンフォード大学とカリフォルニア大学バークレー校の研究者らがTokenGateを発表:トークンゲート型アテンションにより、長文コンテキストのプリフィル処理が最大11.3倍高速化

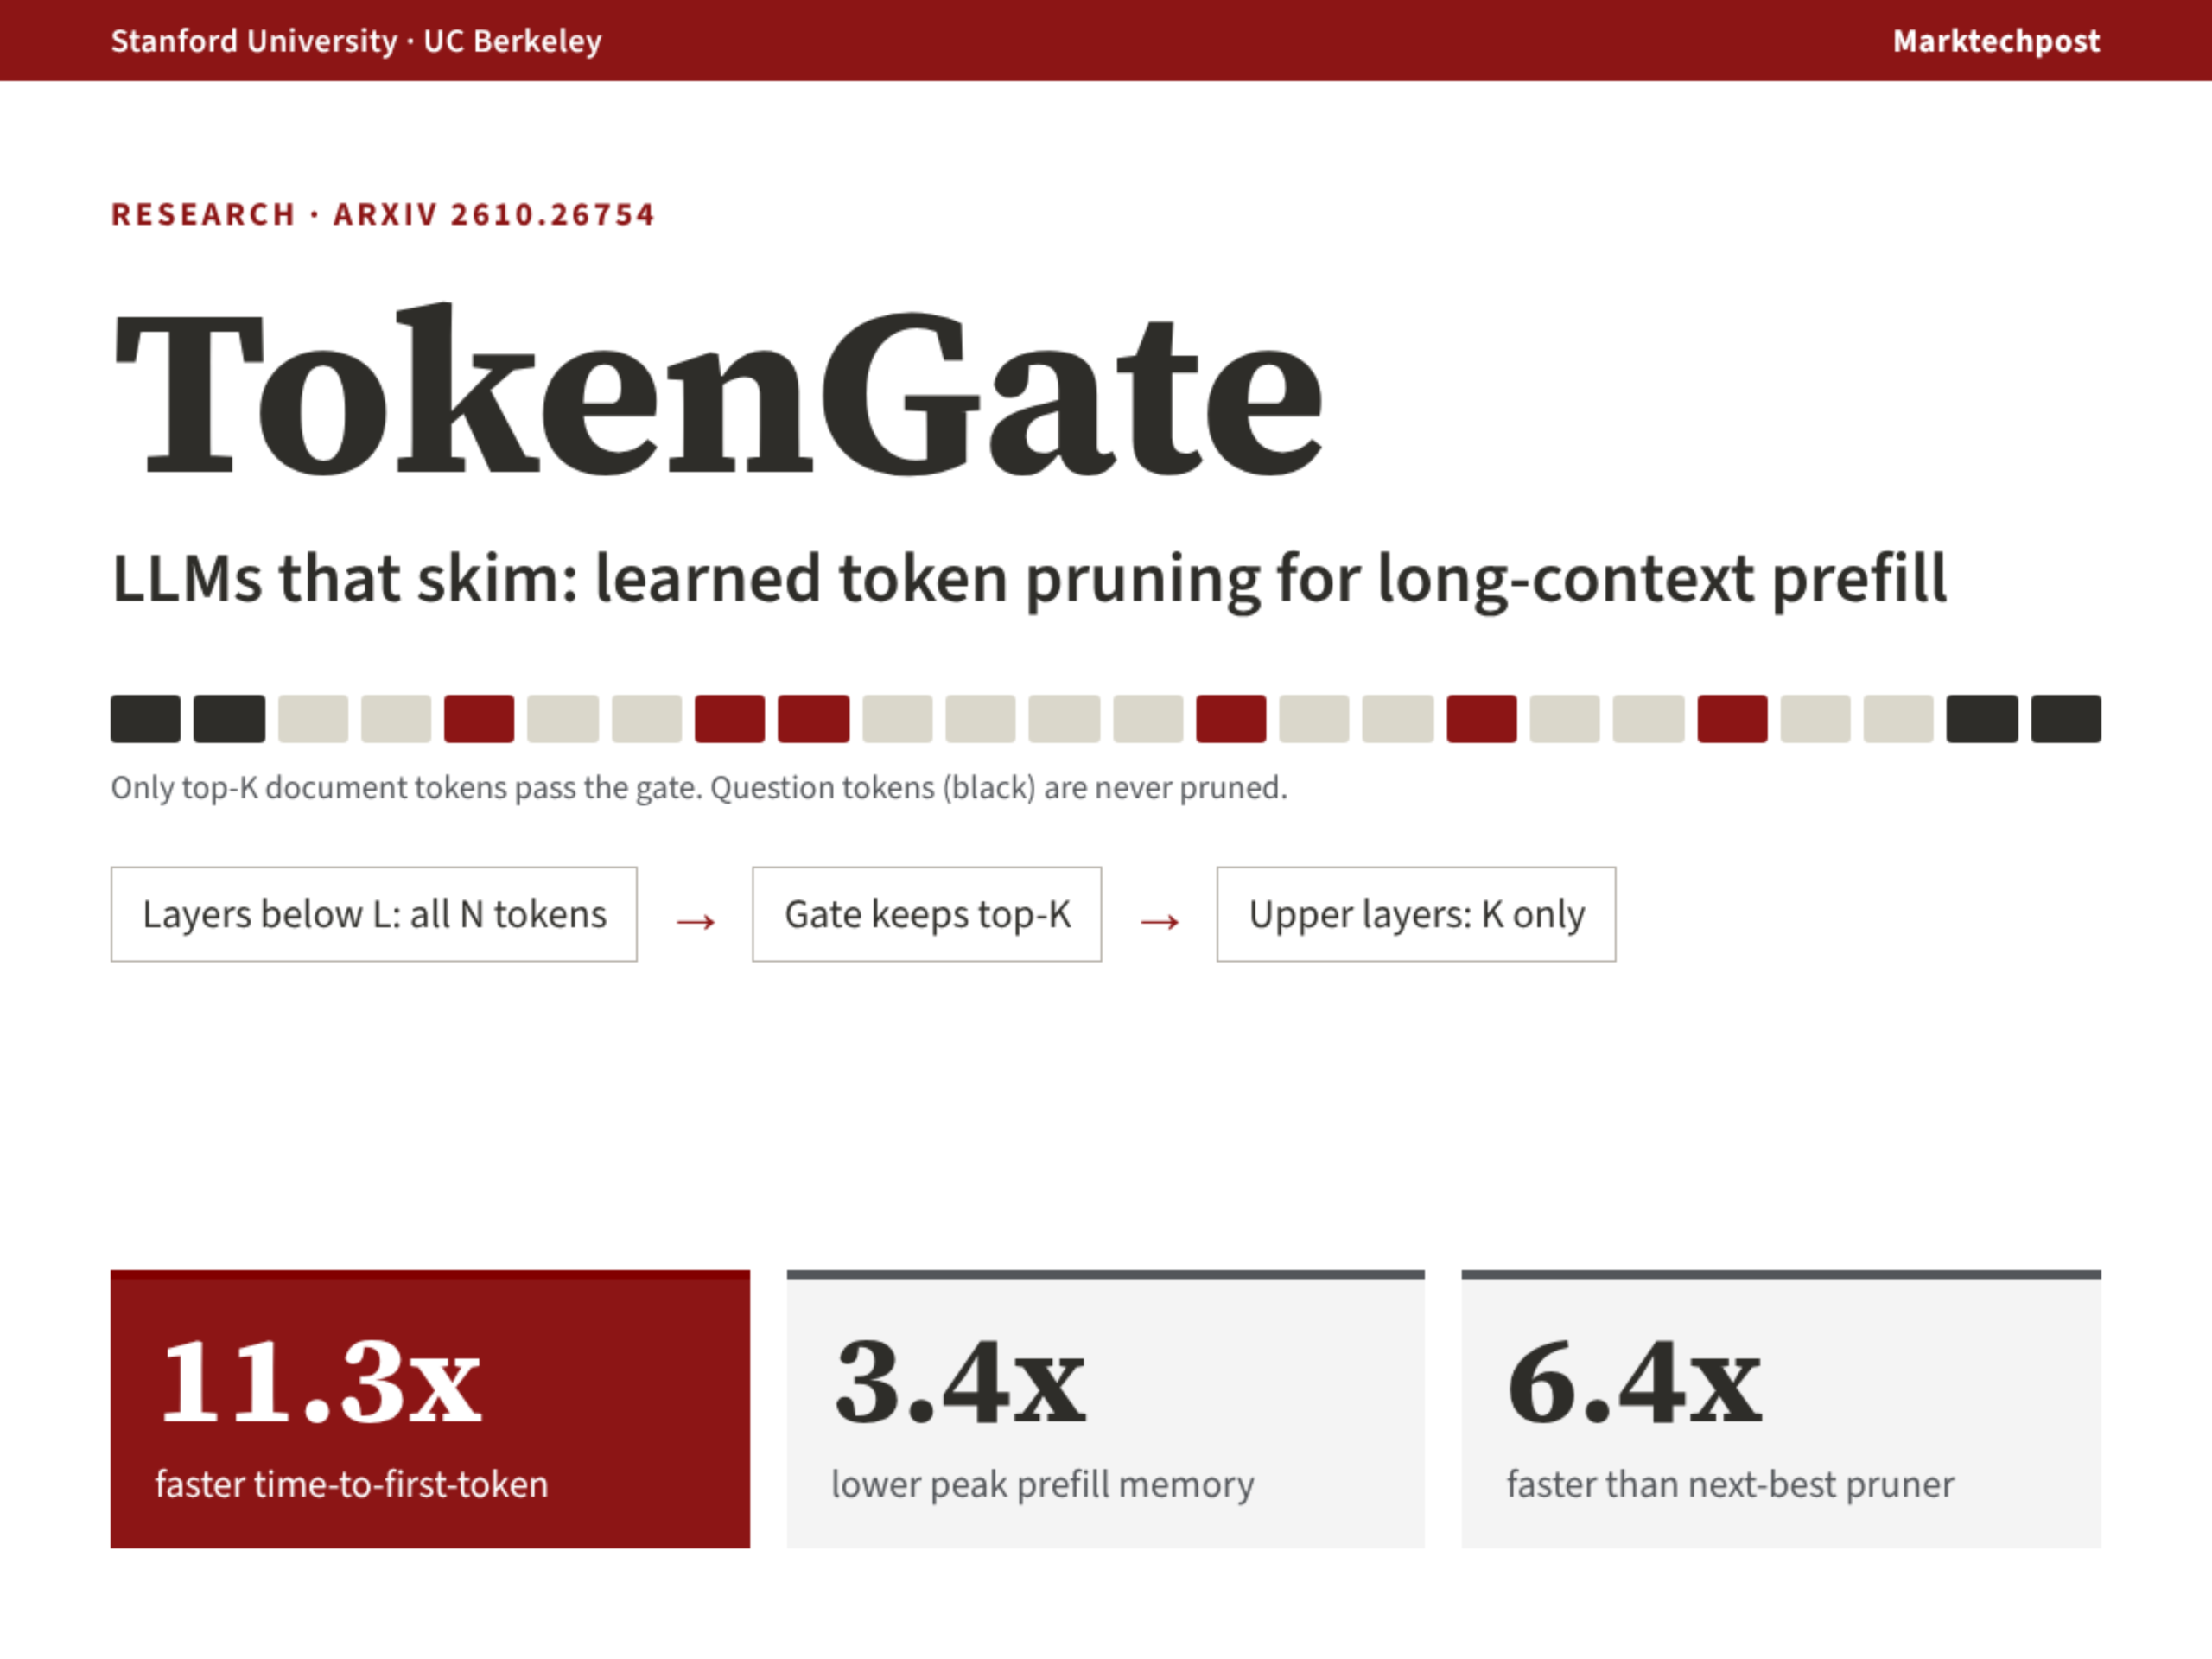
スタンフォード大学とカリフォルニア大学バークレー校の研究者らは、既存の大規模言語モデル(LLM)に適用可能なプラグアンドプレイ型の学習ベースのトークン剪枝モジュール「TokenGate」を提案しました。この手法は、精度を損なうことなく、長文コンテキストに対する初期文字生成時間(TTFT)を1.4倍から11.3倍に加速し、ピークメモリ使用量を1.5倍から3.4倍削減します。関連コードおよびチェックポイントはオープンソースとして公開されています。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
経緯と関連報道

KimiがK3.1 Proを発表:エンドポイントタスク能力がトップに躍進、シミュレーションによるデバッグとマルチモーダルプログラミングにより具現知能の原型を示す

Kimiは2026年10月25日にK3.1 Proモデルを発表し、Terminal-Bench 4.0のタスクテストにおいて成功率67.2%で首位に立った。また、エミュレーターのバグを自律的に修正し、物理シミュレーション、音声解析、3Dシーン構築、動画編集といった多様なタスクをこなす能力を備えており、身体拡張型知能技術の道筋を探る方向性を示している。

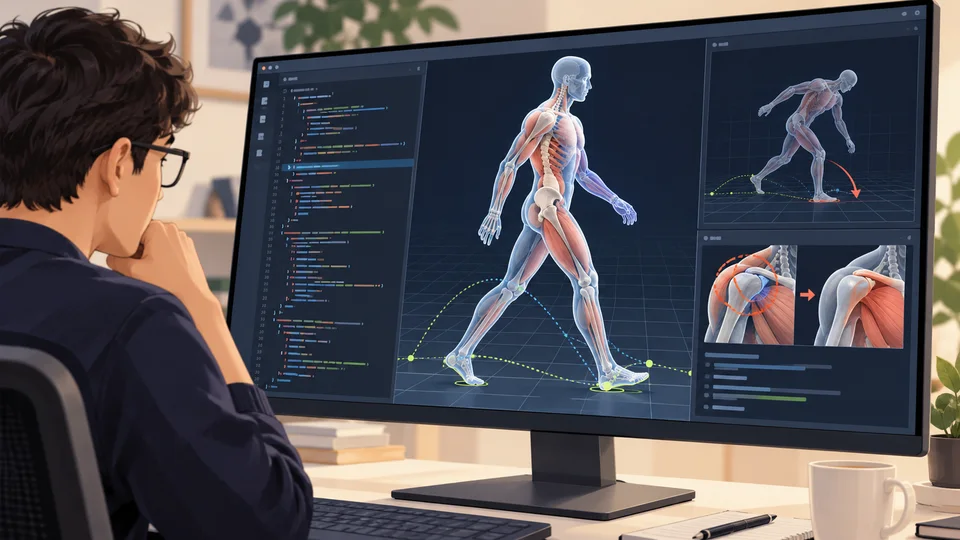
根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

注目する理由:本資料は、钛媒体が許諾して公開した実測レポートに基づいており、Artificial Analysis、Terminal-Bench 4.0 などの権威ある第三者評価データ、公式による自主テスト結果、ならびに著者による多様なシーンにおける機能検証を網羅しています。K3.1 Pro の実行性能、シミュレーションのクローズドループ、マルチモーダルプログラミングにおける実質的な進歩に焦点を当てるとともに、性能上の限界や未公表の情報(例:Flash/Ultra はまだリリースされていない)についても明示しており、事実確認および出典表示の要件に準拠しています。

経緯と関連報道

四分の一PRは「AIゴミ」だ!Linux財団が新たな報告書を発表:AIによるコード生成は52%速くなったが、オープンソースのメンテナーはかえって疲れている

Linux財団は10月20日に発表した報告書で、生成型AIによりコード作成にかかる時間は平均52%短縮された一方で、オープンソースプロジェクトのメンテナーらは、プルリクエストの約25%が低品質な「AIスロップ」に該当すると推定していると指摘しました。大規模プロジェクトではその割合が31%にまで上昇しています。報告書は、効率向上による恩恵が審査やガバナンスのコスト削減には必ずしも反映されておらず、正式なAI貢献ポリシーを策定しているプロジェクトは全体の35%にとどまっていることを明らかにしています。さらに、メンテナーの疲弊と信頼不足が顕在化している状況も浮き彫りにされています。

経緯と関連報道

ネパール語・英語混在の音声認識に関する新たなベンチマークと、合成から実際への二段階適応フレームワークを公開

研究者は2026年10月24日、arXivに論文(番号2610.30860v1)を公開し、自発的なポッドキャスト環境向けのネパール語–英語コードスイッチングASRベンチマークを初めて提案しました。このデータセットには13,044件の実際の文(総計15.45時間分)が含まれており、さらに合成音声から実際の音声への二段階適応手法を設計しました。具体的には、まず0.95時間分の多話者TTS合成音声による監督下での微調整を行い、次いでスクリプト付き報酬を用いたグループ相対方策最適化(GRPO)を導入しています。

Synthetic-to-Real Code-Switched ASR: A Spontaneous Nepali-English Podcast Benchmark

注目する理由:本研究は、低資源言語間のコードスイッチングにおけるASRにおけるスクリプトの混同と切り替えポイントの誤り率の高さという核心的な課題に正面から取り組み、厳格なデータ監査により機械翻訳による漏洩や音響ループを防止するとともに、検証用テキスト、タイムスタンプ、エピソードメタデータおよび再構築スクリプトをすべて公開しています。実験結果は統計的に有意であり(p≤0.001)、単言語ベースラインにおいて汎化安定性も確認されています。

経緯と関連報道

研究により、コーディングエージェントのベンチマークにおける「規範–オラクルギャップ」の問題が明らかになった

2026年10月24日にarXivに掲載された論文は、現在主流のコーディング・インテリジェンス・エージェント向けベンチマーク(たとえばSWE-Milestone)には「仕様–オラクルギャップ」が存在すると指摘している。すなわち、タスクの自然言語による記述には、テストに必要な重要な実装細部(例えば定数名、モジュールパス、正確なエラーメッセージなど)が含まれておらず、その結果、評価では上流のコードを再現する能力が測定されているにすぎず、真の理解力や推論能力が評価されていないという問題がある。

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

注目する理由:本研究は、この種のバイアスを初めて形式的に定義し、5言語をカバーする静的解析ツール(精度89.2%、再現率92.9%)を構築したうえで、SWE-Milestoneにおいて、25のマイルストーンタスクに推論不可能な暗黙的依存関係が存在することを実証的に明らかにしました。これにより、失敗率が大幅に上昇する(80.6%対48.4%)ことが示され、現在のランキングが「名前を真似る」タイプのエージェントを体系的に優遇している可能性が浮き彫りになりました。研究成果として、オープンソースの解析ツールと修正リソースが公開されており、方法論的価値と実践的価値の両面から貢献しています。

経緯と関連報道

DiscordがMarkdownプレビューのレンダリング機能を更新:表とフォーマット表示をサポート

Discordは近日中にアップデートをリリースし、.mdファイルのアップロード後のプレビュー表示を改善しました。これにより、Markdown形式(表や太字、リストなど)が正しくレンダリングされるようになり、もはや元のシンボルコードのみが表示される状態ではなくなりました。

経緯と関連報道

Amazon Pollyの生成エンジンが大幅にアップグレード:新たに14種類の音声を追加し、ヒンディー語とフィンランド語の生成式音声にも初対応、コード不要で移行可能

Amazon Pollyの生成エンジンが大幅にアップグレードされ、音声の自然さ、正確性、感情表現力が顕著に向上し、低遅延のストリーミング合成をサポートします。新たに14種類の生成音声が追加され、9つの地域をカバーするとともに、ヒンディー語(Arjun、Kiara)およびフィンランド語(Suvi)の生成音声が初めて一般利用可能になりました。すべてのアップグレードはシームレスな置き換え型で行われるため、API呼び出しやコードの変更は不要です。

経緯と関連報道

Flint-interactive:AIエージェント向けの対話型データ可視化プログラミング言語

マイクロソフト研究院は、表現力が高くセマンティックな対話型データ可視化を構築するための専用言語「Flint-interactive」を発表しました。この言語はコンパイラを通じて、ユーザーの操作(クリックやスワイプなど)を自動的にセマンティックなイベントにマッピングし、高レベルな演算子によってグラフ、テーブル、テキストなどの複数要素間の連動更新を駆動します。これにより、AIエージェントが信頼性の高い対話型可視化を生成する際に必要なコストと開発の複雑さを大幅に削減できます。

経緯と関連報道

OlmoEarth v1.3リリース:世界中の地表を対象とした高性能なオープンソースの衛星埋め込みモデル

アレン人工知能研究所は、OlmoEarth v1.3をリリースし、惑星全体で10メートルの解像度を持つ64次元および128次元の事前計算済み衛星埋め込みベクトルを提供するとともに、対話型探索ツール「Embeddings Explorer」も搭載しています。これにより、コード不要の変更検出、類似領域の検索、軽量な分類モデリングが可能になります。

経緯と関連報道

ディープインサイト:AWSのオープンソース多エージェントシステムは、5つの本番レベルの課題をどのように解決するのか

AWSソリューションアーキテクチャチームが提供するオープンソースのマルチエージェントシステム「Deep Insight」は、CSVデータの自動分析および自然言語によるレポート生成といったユースケースを対象とし、本番環境でよく見られる5つの主要な課題――エージェントのオーケストレーション、役割に応じたモデル選択、安定した運用、安全なコード実行、そして可観測性――に体系的に対応します。また、LGエレクトロニクスやre:Invent 2025 TechReconなど、実際の活用シーンにおいても実証済みです。

経緯と関連報道

RecursiveがFlintをリリース:AI主導で開発され、ローカルで動作する軽量なプログラミングモデル

AIスタートアップ企業Recursiveは、オープンソースのコーディングモデル「Flint」を発表し、その開発プロセスは主に自社開発のAI研究システム「Eureka Machine」によって行われたと述べています。このモデルはパラメータ数がわずか400億で、実測では25億の活性化を有しており、M4 Pro MacBookなどの一般的なノートPCでもオフラインで動作し、推論速度は131トークン/秒に達します。また、SWE-Benchなどのベンチマークにおいて、同規模の多くのモデルを上回る性能を示しています。

経緯と関連報道

OpenAIの最新GPT-6シリーズモデルが、Google CloudおよびAntigravityプラットフォームに導入される予定です。

OpenAIのGPT-6および6.1シリーズの最先端モデル(Astra、Sol、Luna)は、今後数週間以内にGoogle Cloud Model Gardenに導入され、Googleのエージェント駆動型プログラミングツールAntigravityにも統合される予定です。これにより、GoogleはGemini、Claude、GPTという三大クローズドソースの大規模言語モデルを同時に提供する初の主要クラウドサービスプロバイダーとなります。

経緯と関連報道

Claude Mods:注意力インターフェースの初の実践、人間がプログラミング可能なエージェントインタラクション層

Claude Mods は、Anthropic が提供する Claude Code のプログラマブルなプラグインシステムで、『Attention Interface』の初期形態を示しています。これは、従来の機械向けエージェント実行時フレームワーク(agent harness)から、人間の注意力に焦点を当てたカスタマイズ可能なインタラクション層へと転換したものです。ユーザーは TypeScript や JS を用いて Mods を作成したり、自然言語で Claude に自動生成を指示したりすることで、いつ中断されるか、どのような内容を閲覧するか、どのような意思決定を行うかを自在に制御できます。

経緯と関連報道

Claude Mods:プログラマブルな注意機構インターフェースにより、人間とAIエージェントの協働パラダイムを再定義

Claude Mods は、Anthropic が提供する開発者向けのプログラマブルなプラグインシステムであり、エージェントハーネスがマシン側のインターフェースから人間側のインターフェース――すなわち「アテンション・インターフェース」(Attention Interface)――へと移行したことを示しています。これにより、ユーザーは TypeScript/JavaScript を用いて Claude Code の動作やレンダリング、インタラクションロジックをカスタマイズし、人間とAIが共同でワークフローを設計できるようになります。この仕組みは、You Should Know などの組み込み機能にもすでに活用されており、ユーザーによる独自の構築や、Claude の支援によるプラグインの生成もサポートしています。

経緯と関連報道

NVIDIAがKumo Relationalを発表:教師あり学習を超える、トレーニング不要の構造化データ向け基礎モデル初号機

NVIDIAは、企業向けリレーショナルデータベース上で離職予測、不正検知、需要予測などの予測タスクを直接実行できる、事前学習済みのリレーショナル基礎モデル「Kumo Relational」を発表しました。タスクの微調整や特徴量エンジニアリング、テーブルの平坦化は不要です。15のデータベースにまたがる41のベンチマークにおいて、XGBoostなどの教師ありモデルを総合的に上回り、SAP SALTの企業向けベンチマークではMRR指標でAutoGluonを8%上回りました。また、最大5,000億行規模のデータベースに対応し、Predictive Query Language(PQL)によりコードゼロで予測呼び出しを実現します。

経緯と関連報道