본문으로 건너뛰기
AI NEWS JOURNAL
FOLLOW THE THREAD

AI 코딩

주제별로 새로운 사실과 후속 변화를 따라갑니다.

발행 시간순

Kimi, K3.1 Pro를 출시하며 용량 증가와 가격 인하로 Opus 5.5에 도전합니다

작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는
진행 상황 및 관련 보도

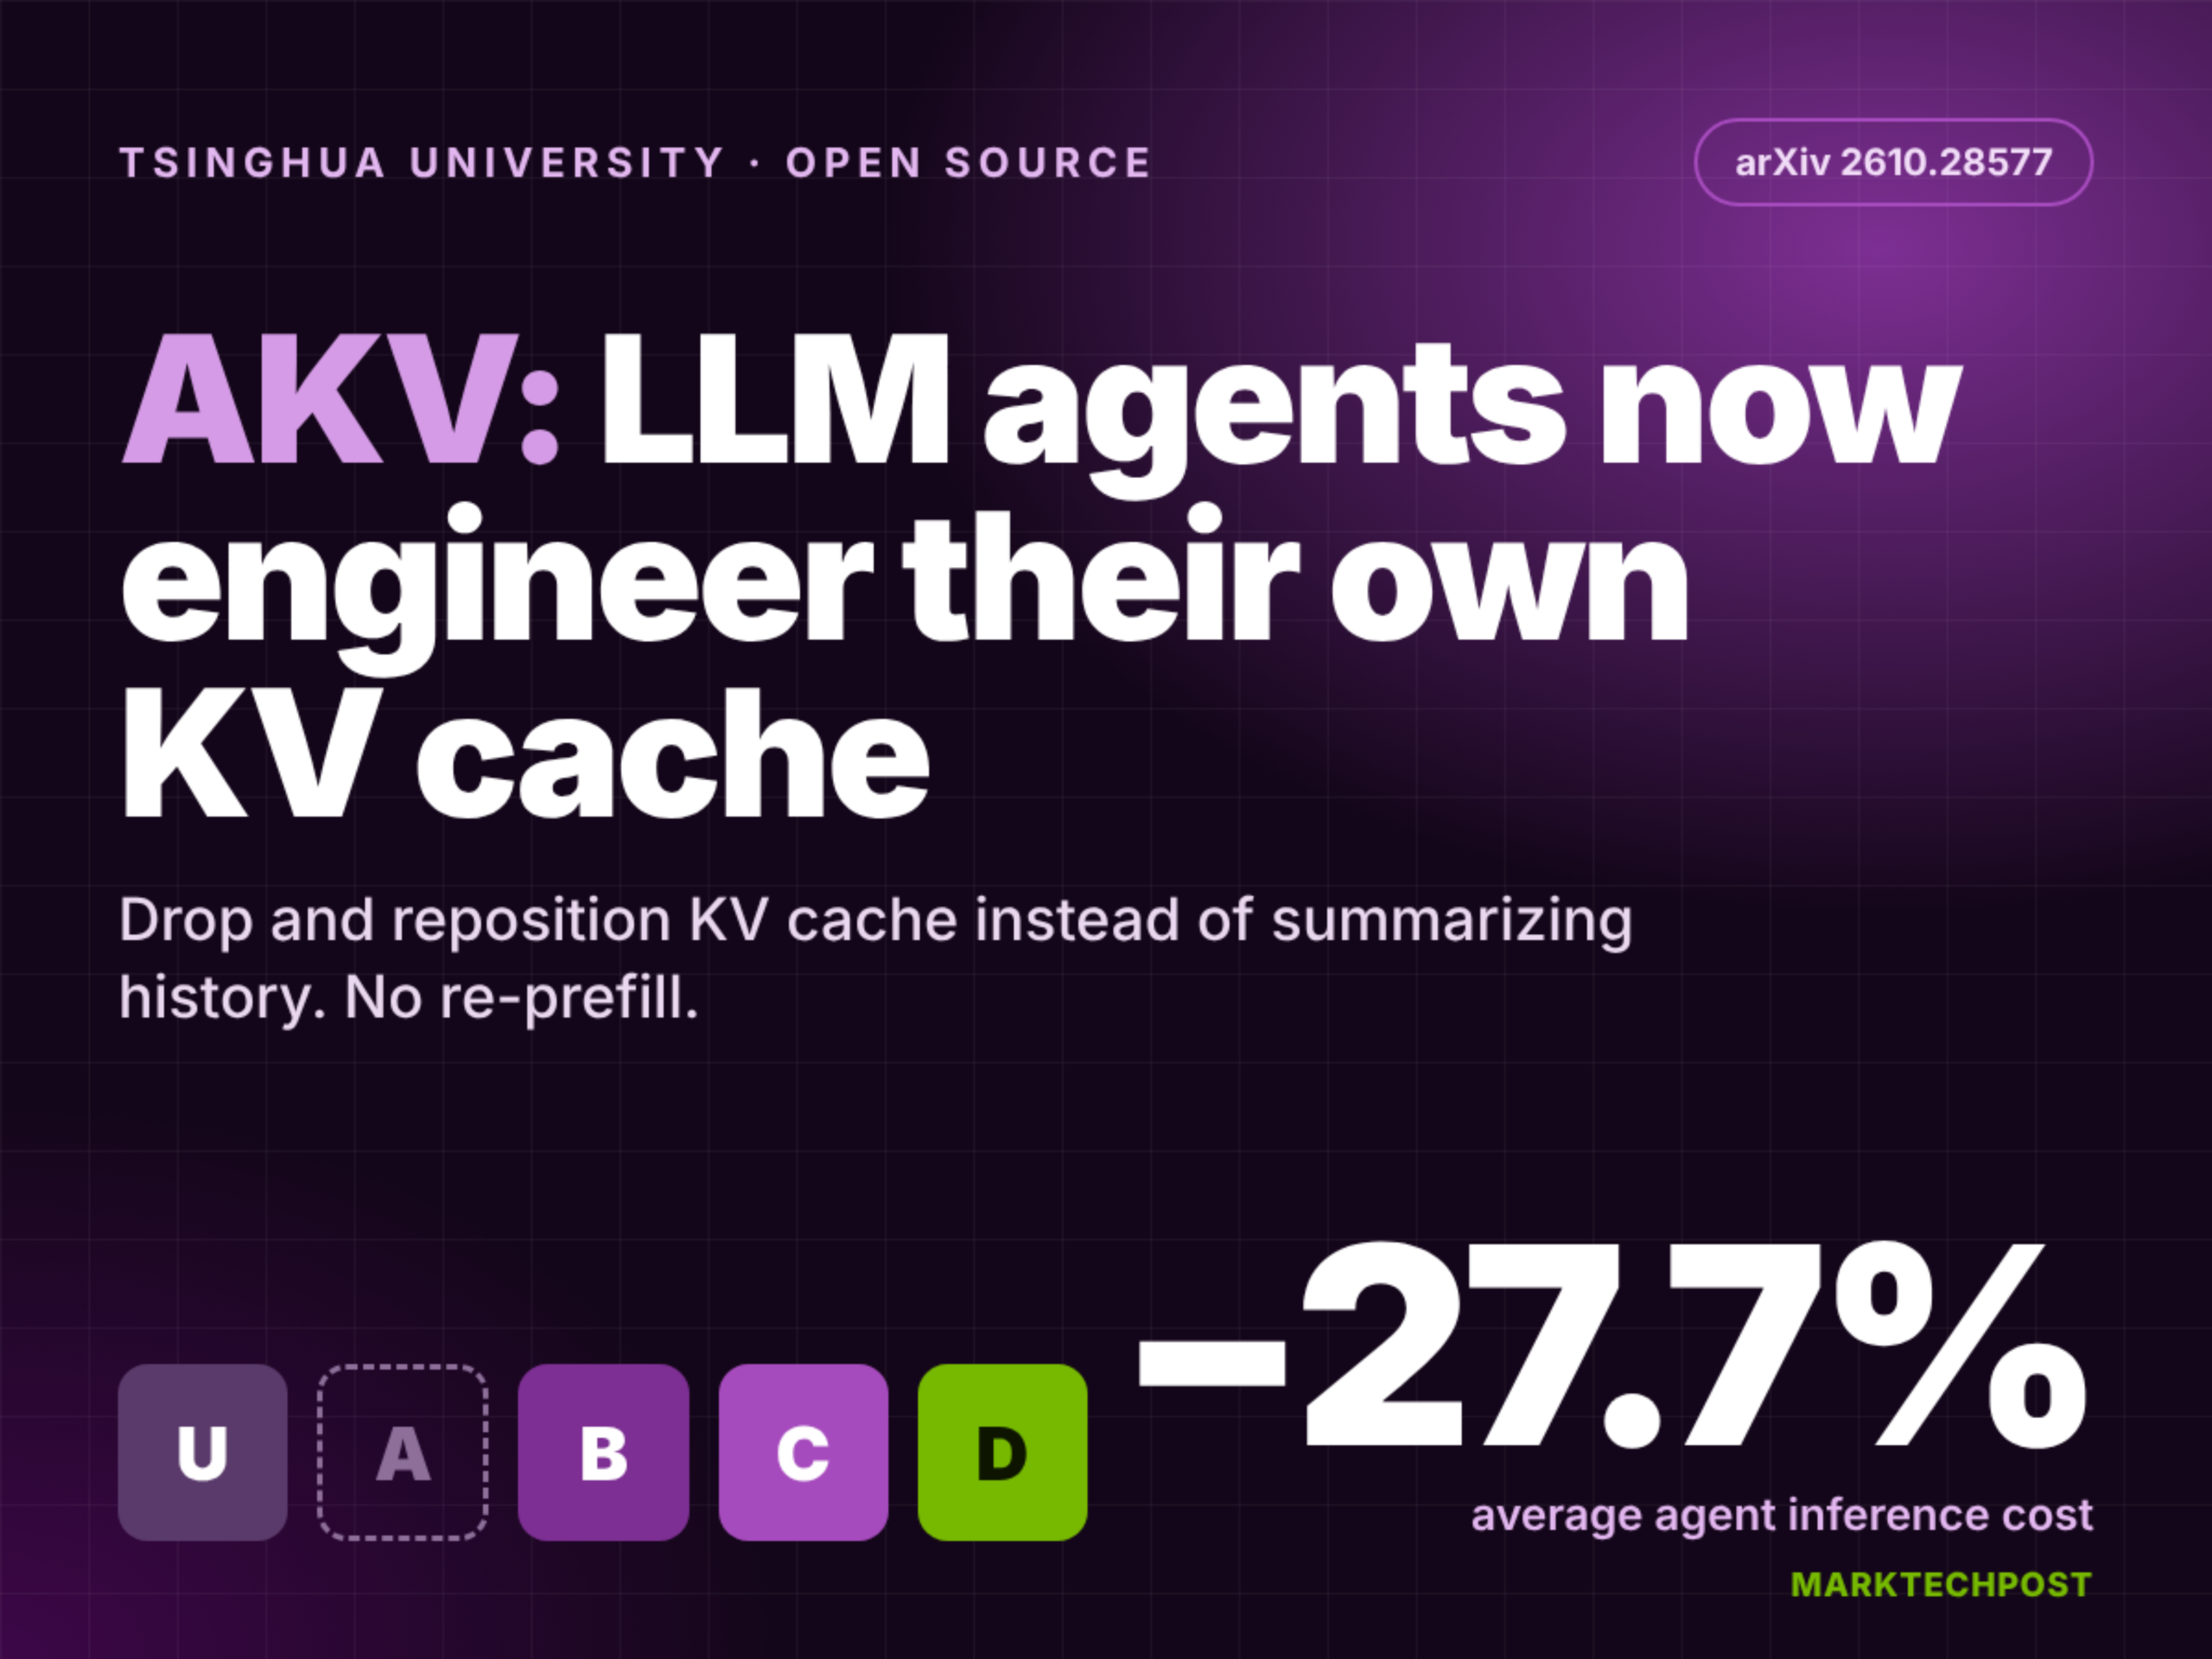
칭화대학교와 홍콩중문대학교가 공동으로 오픈소스 AKV를 출시했습니다: LLM 에이전트를 위한 KV 캐시 엔지니어링 서비스 시스템

칭화대학교와 홍콩중문대학교의 연구진은 2026년 10월 26일, SGLang 기반으로 구축된 대규모 언어모델(LLM) 에이전트 전용 KV 캐시 엔지니어링 서버인 AKV를 오픈소스로 공개했습니다. 이 시스템은 기존의 텍스트 히스토리 요약 방식이 아닌, 에이전트가 스스로 KV 캐시를 적극적으로 버리고 재배치하도록 함으로써, 4개의 에이전트 벤치마크에서 추론 비용을 평균 27.7% 절감하고, 과제 평균 점수를 1.7점 상승시켰습니다. 해당 코드는 Apache-2.0 라이선스를 적용했으며, 현재 Qwen, GPT-OSS-120B, MiniMax-M2.7 등의 모델을 지원합니다.

Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

추천 이유:이 성과는 LLM 에이전트의 효율적 추론을 위한 새로운 패러다임을 제시합니다. 텍스트 절단이나 요약에 의존하는 ‘컨텍스트 엔지니어링’과 달리, AKV는 KV 캐시 상태를 직접 조작하여 중복 프리필을 방지함으로써 장거리 상호작용에서의 KV 부하를 크게 완화합니다. 실제 실험 결과, 높은 동시성 환경에서 P95 지연 시간이 229.9초에서 30.6초로 감소하여 명확한 엔지니어링 가치와 재현 가능성을 입증했습니다. 해당 정보는 MarkTechPost가 발표한 권위 있는 기술 보고서에 근거하며, 게시일시(2026-10-26T07:56:45Z)가 현재 시각과 일치해 최신 공개된 진행 상황임을 나타냅니다.

진행 상황 및 관련 보도

KVStream: 대규모 LLM 서비스에서의 KV 캐싱을 위한 적응형 병렬 스토리지 관리

arXiv:2610.31827v1 발표 유형: 신규 초록: 에이전트 기반, 코드 작성 및 문서 처리 워크로드를 위한 장문 컨텍스트 LLM 서비스에서는 키-값(KV) 캐시가 GPU와 호스트 메모리를 초과하여 사용되므로, 접두사 검색을 위한 추론 단계에서 스토리지 I/O가 핵심 경로로 작용하게 됩니다. 단일 노드 로컬 NVMe는 모든 검색 작업을 담당하는 반면, 노드들이 이미 마운트한 병렬 파일 시스템이나 클라우드 파일 스토어에는 거의 추론 트래픽이 발생하지 않습니다. 우리는 이러한 계층 간의 접두사 검색을 집합 대역폭 스케줄링으로 포착하고, 한 단계의 읽기 작업을 일괄 처리하며, 전방향 패스 이후에 쓰기를 지연하고, 각 청크를 모든 계층에 복제하며, 각 계층이 비워질 때 다음 미처리 청크를 적응적으로 요청하도록 하는 KVStream이라는 KV 캐시 엔진을 제안합니다. 우리의 성능 모델은 이 라우팅 방식이 집합적

KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving
진행 상황 및 관련 보도

다중 에이전트 LLM 시스템에서의 의사소통 실패 이해

arXiv:2610.32060v1 발표 유형: 신규 초록: 다중 에이전트 LLM 시스템은 토론, 증거 공유 및 상호 교정을 통해 추론 능력을 향상시키는 것을 목표로 하지만, 상호작용 과정에서는 최종 정확도만으로는 설명할 수 없는 다양한 실패가 발생할 수 있습니다. 에이전트들은 지나치게 빨리 수렴하거나, 이견을 무시하거나, 올바른 소수 의견을 억압하거나, 여러 라운드에 걸쳐 잘못된 프레임을 유지하는 등의 문제를 겪을 수 있습니다. 우리는 의료 QA, 코딩, 금융, 다중 홉 추론, 윤리, 그리고 체화된 텍스트 작업 등 다양한 분야에서 수집된 3,211개의 실패한 다단계 대화 트래젝터리를 바탕으로, 데이터셋과 시스템 설계별 실패 분포, 라운드 수준의 오류 동역학, 복구 난이도, 다수 의견 전환, 소수 의견 신호 억압, 그리고 자가 보고된 신뢰도 등을 분석하기 위한, 데이터셋 기반의 의사소통 실패 분류체계를 제시합니다. 이를 통해 우리는 다음과 같은 사실을 발견했습니다.

진행 상황 및 관련 보도

LangChain이 ‘기업급 에이전트 프레임워크’의 다섯 가지 핵심 구성 요소를 발표했습니다.

LangChain은 2026년 10월 25일 블로그를 통해, 마케팅, 영업 및 엔지니어링 팀 내부에 AI 에이전트(GTM Agent, OpenSWE, Content Studio)를 도입하며 축적한 다섯 가지 일반적인 아키텍처 원칙을 체계적으로 설명했습니다. 이 원칙에는 네이티브 통합 작업 환경(Slack), 동적 신원 모델(OBO+ 고정 인증 정보), 이중 계층 메모리 메커니즘(전역/사용자 수준), 샌드박스화된 코드 실행, 그리고 높은 비율의 스케줄 기반 실행(수동 트리거 아님)이 포함됩니다. 모든 에이전트는 Managed Deep Agents 플랫폼을 기반으로 구축되었습니다.

추천 이유:이 정보는 LangChain 공식 블로그에서 발행되었으며, 게시일시(2026-10-25T18:06:32.000Z)가 현재 시스템 시간(2026-10-25T23:01:18.857Z)보다 앞서 있습니다. 내용은 이미 도입된 사내 인텔리전트 에이전트의 실제 사례에 중점을 두고 있으며, Slack 스레드 격리, GitHub 계정 소속 논리, Notion/Twitter 권한 계층화 등 구체적인 세부사항을 포함하고 있습니다. 검증되지 않은 예측이나 외부의 주장은 포함되어 있지 않으므로, 시의성과 사실성 요건을 충족합니다.

진행 상황 및 관련 보도

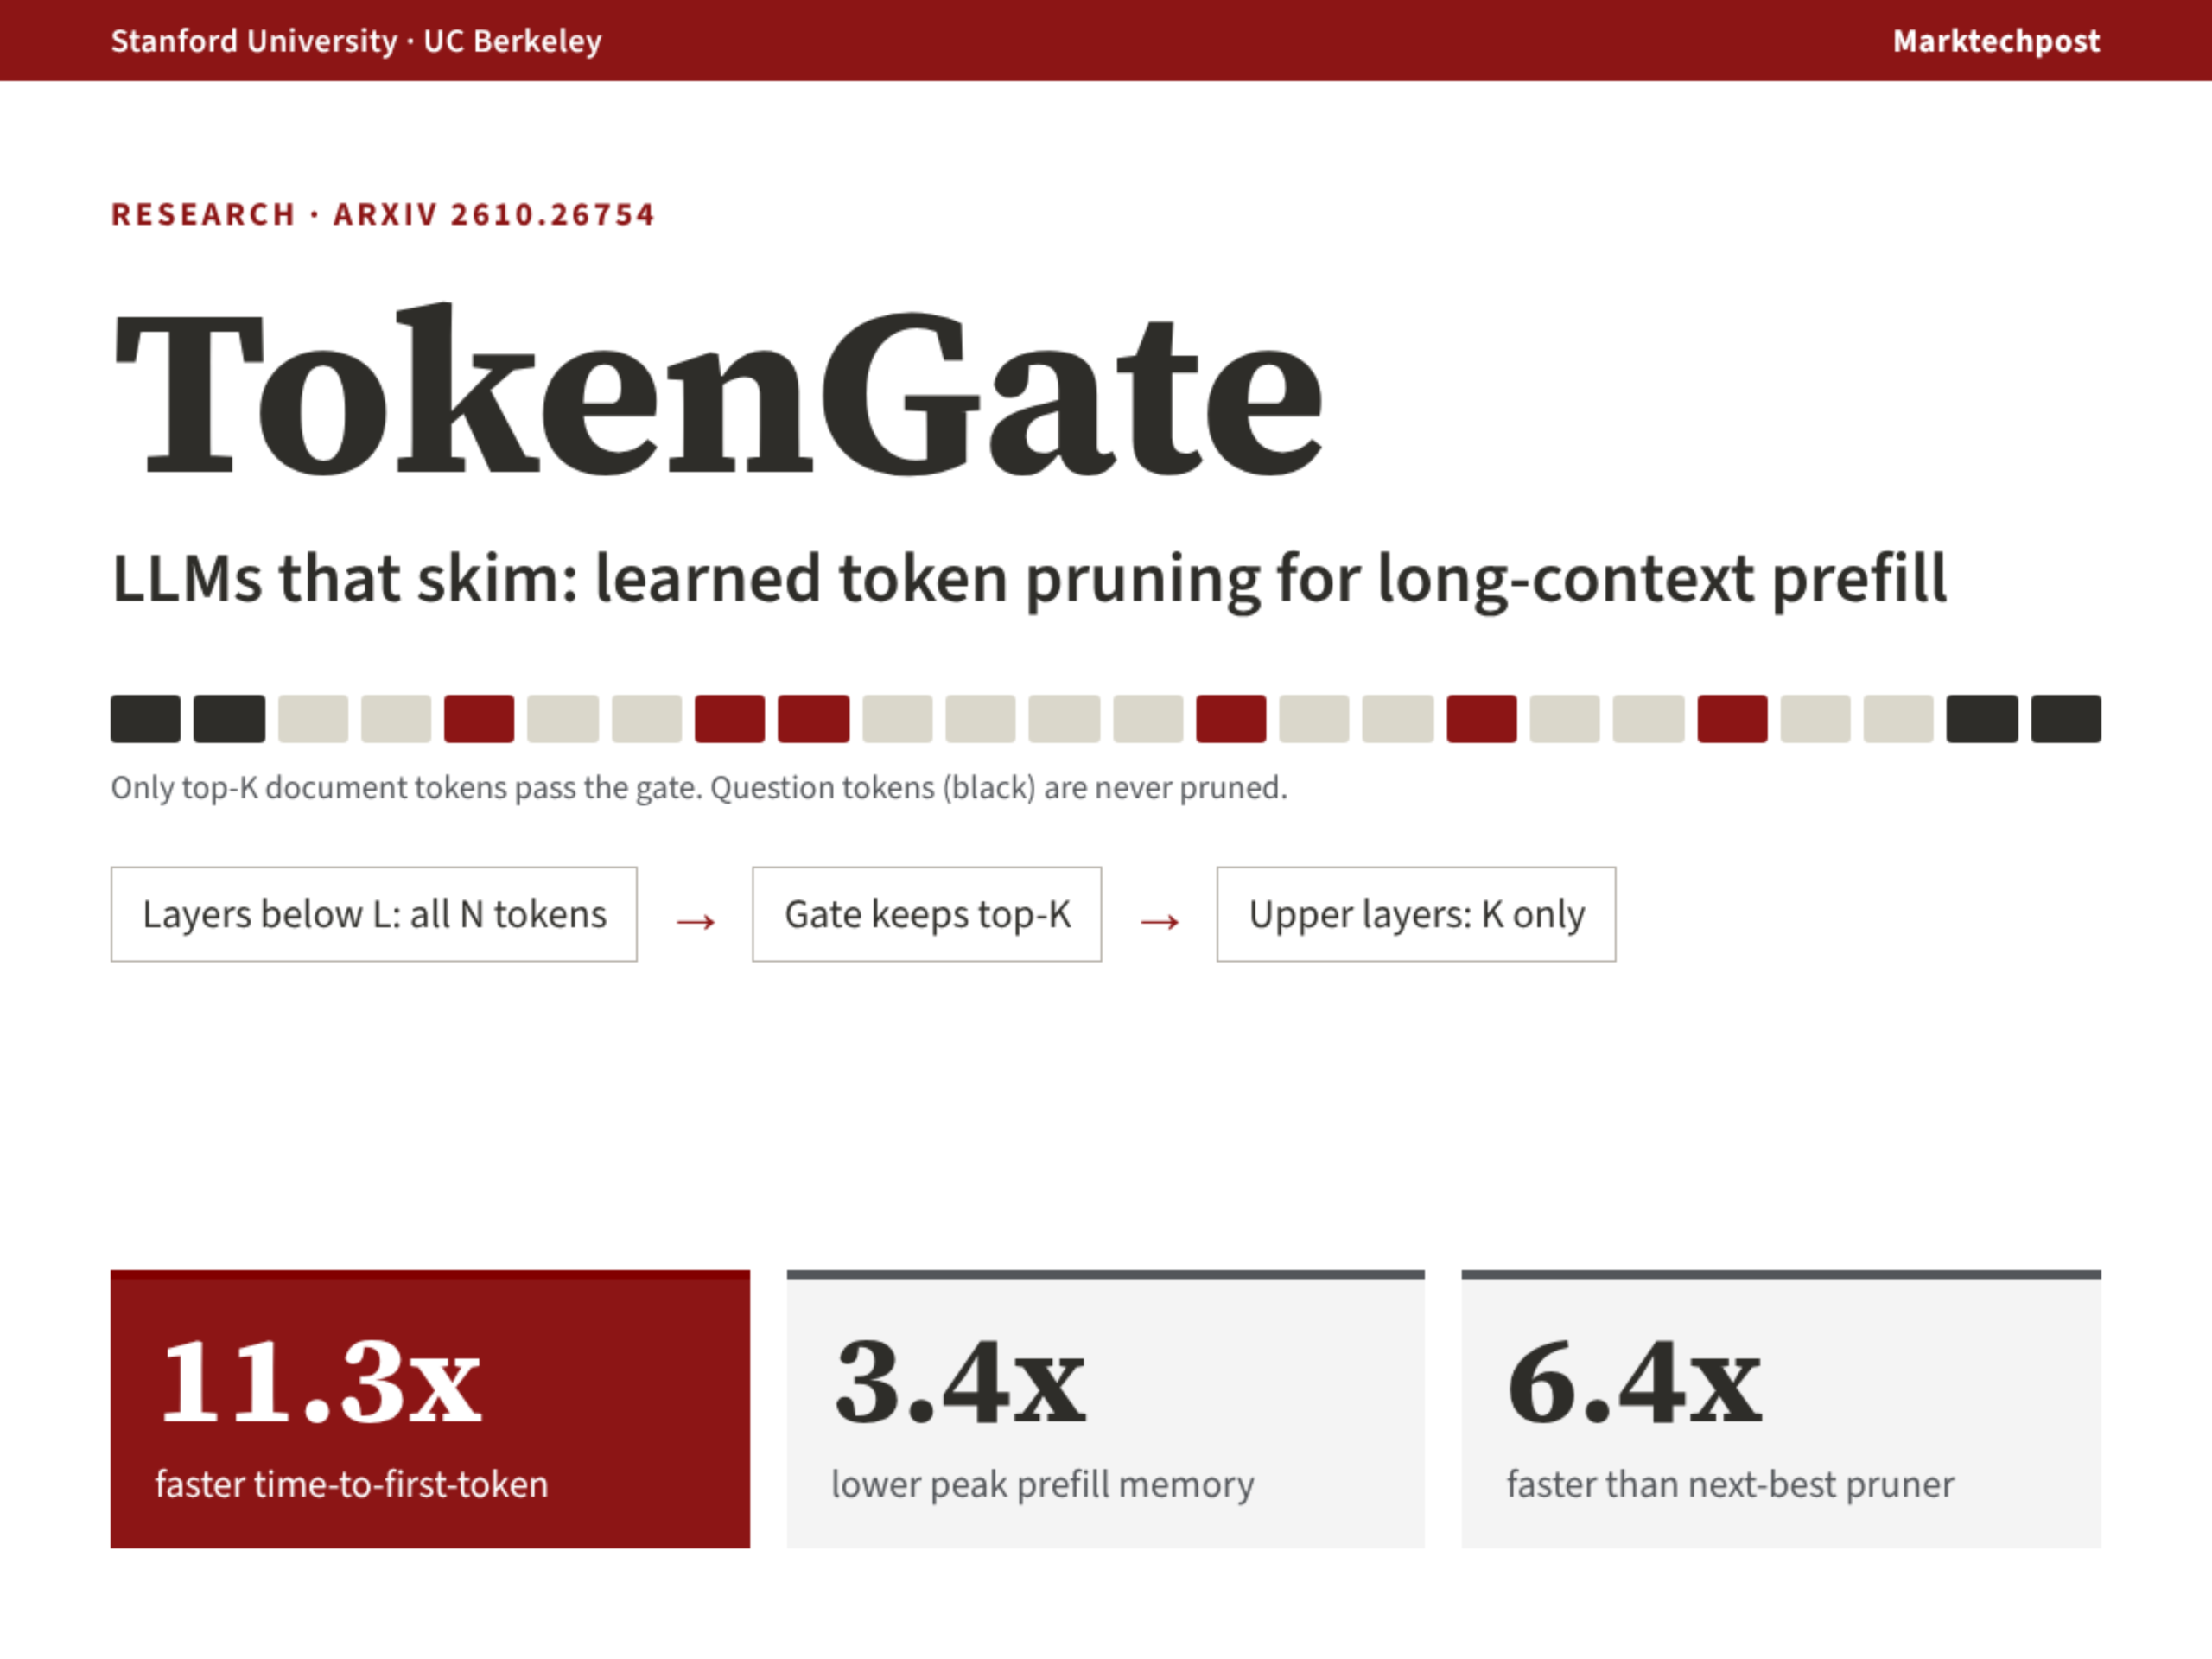
스탠퍼드 대학과 UC 버클리 대학의 연구진이 TokenGate를 발표했습니다: 토큰 기반 접근 제한 주의 메커니즘을 통해 장문 컨텍스트 사전 채우기가 최대 11.3배 더 빨라집니다.

스탠퍼드 대학교와 캘리포니아 대학교 버클리 캠퍼스의 연구진은 기존 대규모 언어 모델(LLM)에 적용 가능한 플러그 앤 플레이 방식의 학습형 토큰 가위 모듈인 TokenGate를 제안했습니다. 이 방법은 정확도를 유지하면서, 긴 컨텍스트를 사전 채워 넣는 첫 글자 생성 시간(TTFT)을 1.4배에서 최대 11.3배까지 가속화하고, 최대 메모리 사용량을 1.5배에서 최대 3.4배까지 절감합니다. 관련 코드와 체크포인트는 오픈소스로 공개되었습니다.

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
진행 상황 및 관련 보도

Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

4분의 1 PR은 “AI 스팸”이다! 리눅스 재단이 새로운 보고서를 발표했다: AI가 코드 작성 속도를 52% 높였지만, 오픈소스 유지보수자는 오히려 더 힘들어졌다

리눅스 재단은 10월 20일 발표한 보고서에서 생성형 AI가 코드 작성에 소요되는 시간을 평균 52% 단축시켰지만, 오픈소스 프로젝트 유지관리자들은 풀 리퀘스트의 약 25%가 저품질의 ‘AI 슬롭’에 해당한다고 추정했다고 밝혔다. 대규모 프로젝트에서는 이 비율이 31%로 상승했다. 보고서는 효율성 향상의 혜택이 검토 및 거버넌스 비용 감소로까지 동반되지 않았음을 지적하며, 정식 AI 기여 정책을 마련한 프로젝트는 전체의 35%에 불과하고, 유지관리자들의 피로감과 신뢰 부족 문제가 두드러지고 있다고 강조했다.

진행 상황 및 관련 보도

네팔어-영어 혼합 음성 인식의 새로운 벤치마크와 합성에서 실제 데이터로의 이중 단계 적응 프레임워크를 발표했습니다.

연구자는 2026년 10월 24일 arXiv에 논문(번호 2610.30860v1)을 발표하여, 자발적 팟캐스트 환경을 위한 네팔어–영어 코드 스위칭 ASR 벤치마크를 최초로 제안했다. 이 벤치마크는 실제 발화 13,044건(15.45시간 분량)을 포함하며, 합성 음성에서 실제 음성으로 전환하는 두 단계의 적응 방법을 설계했다: 먼저 0.95시간 분량의 다중 화자 TTS 합성 음성을 활용한 감독 미세조정을 수행하고, 이후 스크립트 기반 보상을 도입한 그룹 상대적 정책 최적화(GRPO)를 적용한다.

Synthetic-to-Real Code-Switched ASR: A Spontaneous Nepali-English Podcast Benchmark

추천 이유:이 연구는 저자원 언어 간 코드 전환 ASR에서 스크립트 혼란과 전환 지점 오류율이 높다는 핵심 과제에 정면으로 도전하며, 엄격한 데이터 감사를 통해 기계 번역 유출 및 음향 순환을 원천적으로 차단하고, 모든 검증 텍스트, 타임스탬프, 에피소드 메타데이터 및 재구성 스크립트를 공개했습니다. 실험 결과는 통계적 유의성을 보였으며(p≤0.001), 단일 언어 벤치마크에서도 일반화 안정성을 입증했습니다.

진행 상황 및 관련 보도

연구는 코딩 에이전트 벤치마크에서의 ‘규범-오프체인 오라클 갭’ 문제를 밝혀냈다.

2026년 10월 24일 arXiv에 게재된 한 논문은 현재 주류 코딩 지능 에이전트 벤치마크(예: SWE-Milestone)에 ‘규격–오라클 격차’가 존재한다고 지적한다. 즉, 과제의 자연어 설명에는 테스트에 필요한 핵심 구현 세부사항(예: 상수 이름, 모듈 경로, 정확한 오류 메시지 등)이 포함되어 있지 않아, 평가 결과가 실제로는 상위 코드를 얼마나 재현하는지에 대한 능력을 측정할 뿐이며 진정한 이해와 추론 능력을 반영하지 못한다는 것이다.

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

추천 이유:이 연구는 해당 유형의 편향을 최초로 형식적으로 정의하고, 다섯 가지 언어를 포괄하는 정적 감사 도구를 구축하여 정확도 89.2%, 재현율 92.9%를 달성했으며, SWE-Milestone에서 25개의 마일스톤 작업에 추론할 수 없는 암시적 의존성이 존재함을 실증적으로 밝혀냈습니다. 이는 실패율을 크게 높였으며(80.6% 대 48.4%), 현재 순위표가 ‘명칭 복사’형 에이전트를 체계적으로 선호할 수 있음을 드러냅니다. 연구 결과는 감사 도구와 수정 자료를 오픈소스로 공개하여 방법론적 및 실무적 측면에서 모두 높은 가치를 지닙니다.

진행 상황 및 관련 보도

IQuest-Q1: 에이전트형 CLI 시스템을 위한 기반 모델 역량 강화

arXiv:2610.30949v1 발표 유형: 신규 요약: 우리는 총 320B 파라미터(활성화된 파라미터는 15B)를 갖춘 희소 혼합전문가(MoE) 기반의 에이전트형 기반 모델인 IQuest-Q1을 제시합니다. IQuest-Q1은 세 단계의 프로세스를 통해 개발되었습니다: (1) 안정적이고 효율적인 사전 학습으로, 스테이블 스플릿노름, Muon 및 muP를 두 단계 커리큘럼과 결합하며, 두 번째 단계에서는 코딩 데이터 혼합 비율을 높여 안전한 학습률과 최적 학습률 간의 넓은 안정성 여유를 유지합니다; (2) 세밀한 중간 학습 단계에서는 도메인과 형식 전반에 걸쳐 데이터 혼합을 확대하고 문맥 범위를 점진적으로 확장합니다; 그리고 (3) 다중 스캐폴드와 다중 버전 사후 학습을 통해 SFT, 도메인 특화 RL, MOPD 등을 다양한 스캐폴드에서 결합하여 상호 보완적인 학습 신호를 통합하고 에이전트형 코딩 역량을 강화합니다.

IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
진행 상황 및 관련 보도

Amazon Polly 생성 엔진 대규모 업그레이드: 새로운 14종의 음성 추가, 힌디어와 핀란드어 생성형 음성 최초 지원, 코드 없는 마이그레이션

Amazon Polly 생성 엔진이 대규모 업그레이드를 완료하여 음성의 자연스러움, 정확도 및 감정 표현 능력을 크게 향상시켰으며, 낮은 지연 시간의 스트리밍 합성을 지원합니다. 또한 14종의 생성형 음성이 추가되어 총 9개 지역을 포괄하며, 처음으로 힌디어(Arjun, Kiara)와 핀란드어(Suvi)의 생성형 음성이 범용적으로 사용 가능해졌습니다. 모든 업데이트는 API 호출이나 코드를 수정할 필요 없이 원활하게 교체 가능한 방식으로 이루어집니다.

진행 상황 및 관련 보도

Flint-interactive: AI 에이전트를 위한 대화형 데이터 시각화 프로그래밍 언어

마이크로소프트 연구소는 고 표현력의 의미 기반 대화형 데이터 시각화를 구축하기 위한 전용 언어인 Flint-interactive를 발표했습니다. 이 언어는 컴파일러를 통해 사용자의 동작(예: 클릭, 필터링)을 자동으로 의미적 이벤트로 매핑하고, 고수준 연산자를 활용해 차트, 테이블, 텍스트 등 다양한 요소 간의 연동 업데이트를 구동함으로써, AI 에이전트가 신뢰할 수 있는 대화형 시각화를 생성하는 데 필요한 비용과 개발 복잡성을 크게 절감합니다.

진행 상황 및 관련 보도

OlmoEarth v1.3 출시: 전 세계 지표면을 대상으로 한 고성능 오픈소스 위성 임베디드 모델

앨런 인스티튜트 포 AI는 OlmoEarth v1.3을 발표했으며, 전 행성에 걸쳐 10미터 해상도의 64차원 및 128차원 사전 계산된 위성 임베딩 벡터를 제공하고, 여기에 대화형 탐색 도구인 Embeddings Explorer를 함께 제공합니다. 이 도구는 코드 없이 변경 사항 감지, 유사 지역 검색 및 경량 분류 모델링을 지원합니다.

진행 상황 및 관련 보도

딥 인사이트: AWS 오픈소스 다중 에이전트 시스템이 5대 생산급 도전 과제를 어떻게 해결하는가

AWS 솔루션 아키텍처 팀이 선보인 오픈소스 다중 에이전트 시스템 Deep Insight는 CSV 데이터의 자동 분석과 자연어 보고서 생성을 위한 시나리오를 대상으로 하며, 생산 환경에서 흔히 발생하는 다섯 가지 주요 과제—에이전트 오케스트레이션, 역할 기반 모델 선택, 안정적인 운영, 안전한 코드 실행 및 관찰 가능성—에 대해 체계적으로 대응합니다. 또한 이 시스템은 LG전자와 re:Invent 2025 TechRecon 등 실제 환경에서 이미 검증된 바 있습니다.

진행 상황 및 관련 보도

Recursive, AI 주도로 개발된 로컬에서 실행 가능한 경량 프로그래밍 모델인 Flint을 출시했습니다.

AI 스타트업 Recursive는 오픈소스 코딩 모델 Flint를 출시했으며, 개발 과정의 대부분이 자체 개발한 AI 연구 시스템 Eureka Machine에 의해 이루어졌다고 밝혔다. 이 모델은 파라미터 수가 400억 개에 불과하며, 실제 테스트에서 활성화 수는 25억 개로 확인되었고, M4 Pro MacBook과 같은 일반 노트북에서도 오프라인으로 실행 가능하다. 추론 속도는 초당 131 토큰에 달하며, SWE-Bench 등 벤치마크 테스트에서 동급 규모의 대부분 모델보다 우수한 성능을 보였다.

진행 상황 및 관련 보도

OpenAI의 최신 GPT-6 시리즈 모델이 Google Cloud와 Antigravity 플랫폼에 도입될 예정입니다.

OpenAI의 GPT-6 및 6.1 시리즈 최첨단 모델(Astra, Sol, Luna)은 향후 수주 내에 Google Cloud Model Garden에 출시되며, Google의 에이전트 기반 프로그래밍 도구인 Antigravity에도 통합될 예정입니다. 이로써 Google은 Gemini, Claude, GPT 등 세 가지 주요 폐쇄형 대규모 언어 모델을 동시에 제공하는 최초의 주류 클라우드 서비스 제공업체가 되었습니다.

진행 상황 및 관련 보도

Claude Mods: 주의력 인터페이스의 첫 번째 실천, 인간이 프로그래밍할 수 있는 에이전트 상호작용 계층

Claude Mods는 Anthropic이 출시한 Claude Code의 프로그래밍 가능 플러그인 시스템으로, ‘주의 인터페이스’(Attention Interface)의 초기 형태를 나타냅니다. 이는 기존의 기계 지향형 에이전트 런타임 프레임워크(agent harness)에서 인간의 주의에 맞춘 맞춤형 상호작용 계층으로 전환합니다. 사용자는 TypeScript/JS로 Mods를 작성하거나 자연어를 통해 Claude에게 자동 생성을 요청함으로써, 언제 중단될지, 어떤 내용을 보게 될지, 어떤 결정을 내려야 하는지를 스스로 정할 수 있습니다.

진행 상황 및 관련 보도

Claude Mods: 프로그래밍 가능한 주의력 인터페이스로 인간과 AI 에이전트 간의 협업 패러다임을 재편합니다

Claude Mods는 Anthropic이 출시한 개발자용 프로그래밍 가능 플러그인 시스템으로, ‘에이전트 하네스’가 기계 측 인터페이스에서 인간 측 인터페이스인 ‘어텐션 인터페이스’로 전환됨을 의미합니다. 이를 통해 사용자는 TypeScript/JavaScript를 활용해 Claude Code의 동작, 렌더링 및 상호작용 로직을 맞춤 설정할 수 있으며, 사람과 AI가 함께 워크플로를 설계하는 것을 가능하게 합니다. 이 메커니즘은 You Should Know와 같은 내장 기능에도 이미 적용되어 있으며, 사용자가 직접 플러그인을 구축하거나 Claude의 도움을 받아 생성하는 것도 지원합니다.

진행 상황 및 관련 보도