跳到正文
AI NEWS JOURNAL
FOLLOW THE THREAD

AI 编程

沿着一个主题,追踪新的事实与后续进展。

按发布时间排序

清华与港中文联合开源AKV:面向LLM智能体的KV缓存工程服务系统

清华大学与香港中文大学研究人员于2026年10月26日开源AKV——一个基于SGLang构建、专为大语言模型(LLM)智能体设计的KV缓存工程服务器。该系统通过让智能体主动丢弃并重定位KV缓存(而非传统文本历史摘要),在4个智能体基准测试中平均降低推理成本27.7%,任务平均得分提升1.7分。代码采用Apache-2.0许可证,当前支持Qwen、GPT-OSS-120B和MiniMax-M2.7等模型。
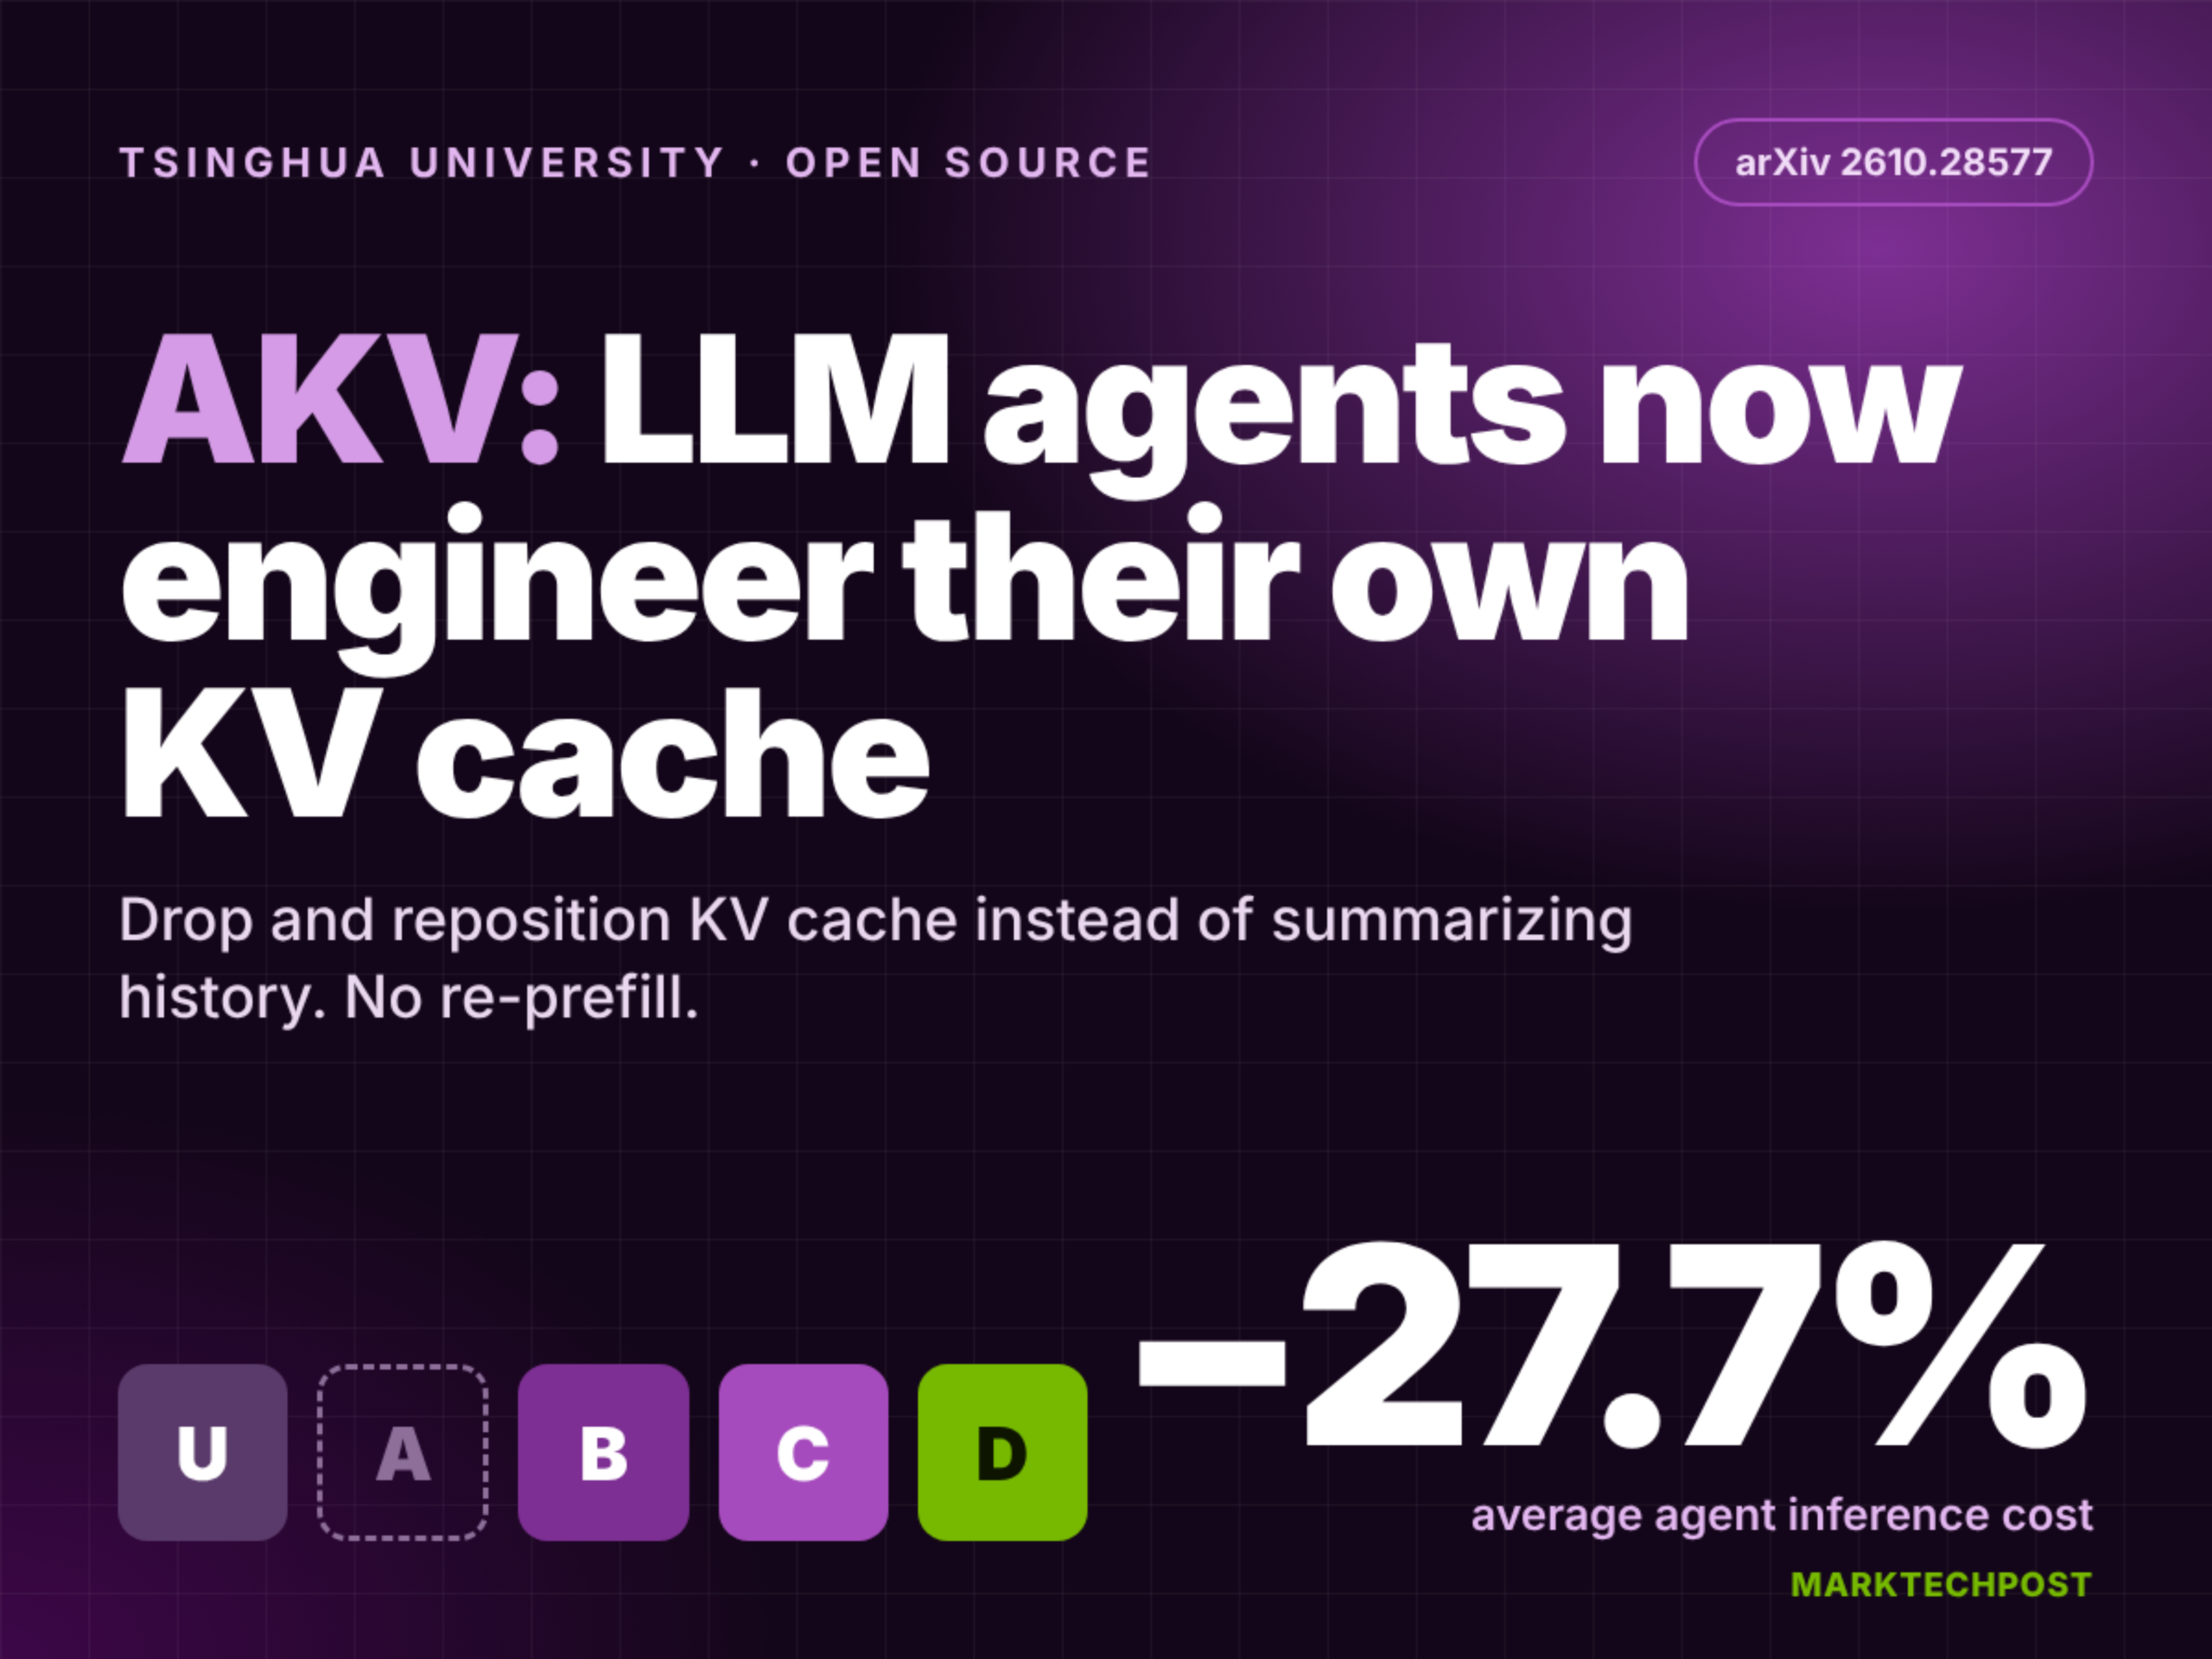
Tsinghua AI Open-Sources AKV, a Cache Engineering Server for LLM Agents on SGLang

推荐理由:该成果代表LLM智能体高效推理的新范式:区别于依赖文本截断或摘要的‘上下文工程’,AKV直接操作KV缓存状态,避免重复prefill,显著缓解长程交互中的KV压力;实测显示高并发下P95延迟从229.9秒降至30.6秒,具备明确工程价值与可复现性;信息源自MarkTechPost发布的权威技术报道,发布时间(2026-10-26T07:56:45Z)与当前时间一致,属最新公开进展。

事件进展与其他报道

TACS-RF:工具驱动的智能体驱动射频与毫米波模块电路综合

arXiv:2610.31882v1 发布类型:新 摘要:我们提出了TACS-RF框架——一种由工具驱动的智能体驱动射频与毫米波模块电路综合方法。在该框架中,大型语言模型(LLM)编码智能体(Claude Opus 4.8)直接调用业界标准的电子设计自动化(EDA)工具,如Cadence Virtuoso/Spectre、Calibre、Cadence EMX以及Ansys HFSS,用于设计射频与毫米波模块。我们通过在90 nm SiGe BiCMOS工艺下对一款240–251 GHz亚太赫兹发射机进行智能体驱动设计,对该框架进行了验证。该智能体半自主地完成了各子模块的设计,包括具备二次谐波提取功能的60 GHz推挽式Colpitts压控振荡器、多级差分共栅功率驱动器、推挽式倍频器、差分蝴蝶天线以及所有级间匹配网络。

TACS-RF: Tool-driven Agentic Circuit Synthesis of RF and mmWave Modules
事件进展与其他报道

KVStream:面向大规模LLM推理的KV缓存自适应并行存储管理

arXiv:2610.31827v1 发布类型:新 摘要:针对智能体驱动、编码及文档工作负载的长上下文大语言模型服务,会重复使用那些键值(KV)缓存超出GPU和主机内存容量的前缀,从而导致在推理阶段为获取这些前缀而产生存储I/O,使其成为关键路径。单个节点本地的NVMe设备承担了所有检索任务,而各节点已挂载的并行文件系统或云文件存储几乎不承载任何推理流量。我们将前缀检索视为跨这些层级的聚合带宽调度问题,并提出了KVStream——一种KV缓存引擎,它将某一步骤的读取操作进行批处理,在前向传播之后延迟写入,在每一层级上复制每个数据块,并允许每个层级在空闲时自适应地获取下一个未读取的数据块。我们的性能模型表明,这种路由方式能够实现聚合

KVStream: Adaptive Parallel Storage Management for KV Caching in Large-Scale LLM Serving
事件进展与其他报道

理解多智能体大型语言模型系统中的通信故障

arXiv:2610.32060v1 发布类型:新 摘要:多智能体大型语言模型系统旨在通过辩论、证据共享和相互纠正来提升推理能力,但交互过程也可能引入一些仅凭最终准确率无法解释的失败现象。例如,智能体可能过早趋于一致、忽视异议、压制正确的少数派答案,或在多轮对话中固守错误的框架。我们提出了一套基于语料库的沟通失败分类体系,该体系源自医疗问答、编程、金融、多跳推理、伦理以及具身文本任务等领域的3,211条失败的多轮对话轨迹。借助这一分类体系,我们分析了不同数据集与系统设计下的失败分布、各轮次的误差动态、恢复难度、多数派转变、少数派信号被压制的现象,以及自我报告的信心水平。我们发现……

事件进展与其他报道

LangChain发布“公司级智能体框架”五大核心组件

LangChain于2026年10月25日发布博客,系统阐述其在营销、销售与工程团队内部部署AI智能体(GTM Agent、OpenSWE、Content Studio)所沉淀的五大通用架构原则:原生集成工作环境(Slack)、动态身份模型(OBO+固定凭证)、双层记忆机制(全局/用户级)、沙箱化代码执行、高比例调度运行(非手动触发)。所有智能体均基于Managed Deep Agents平台构建。

推荐理由:该资讯源自LangChain官方博客,发布时间(2026-10-25T18:06:32.000Z)早于当前系统时间(2026-10-25T23:01:18.857Z),内容聚焦已落地的内部智能体实践,细节具体(如Slack线程隔离、GitHub账号归属逻辑、Notion/Twitter权限分层等),未含未经验证的预测或外部宣称,符合时效性与事实性要求。

事件进展与其他报道

斯坦福大学与加州大学伯克利分校的研究人员推出 TokenGate:基于令牌的注意力机制使长上下文预填充速度提升高达 11.3 倍

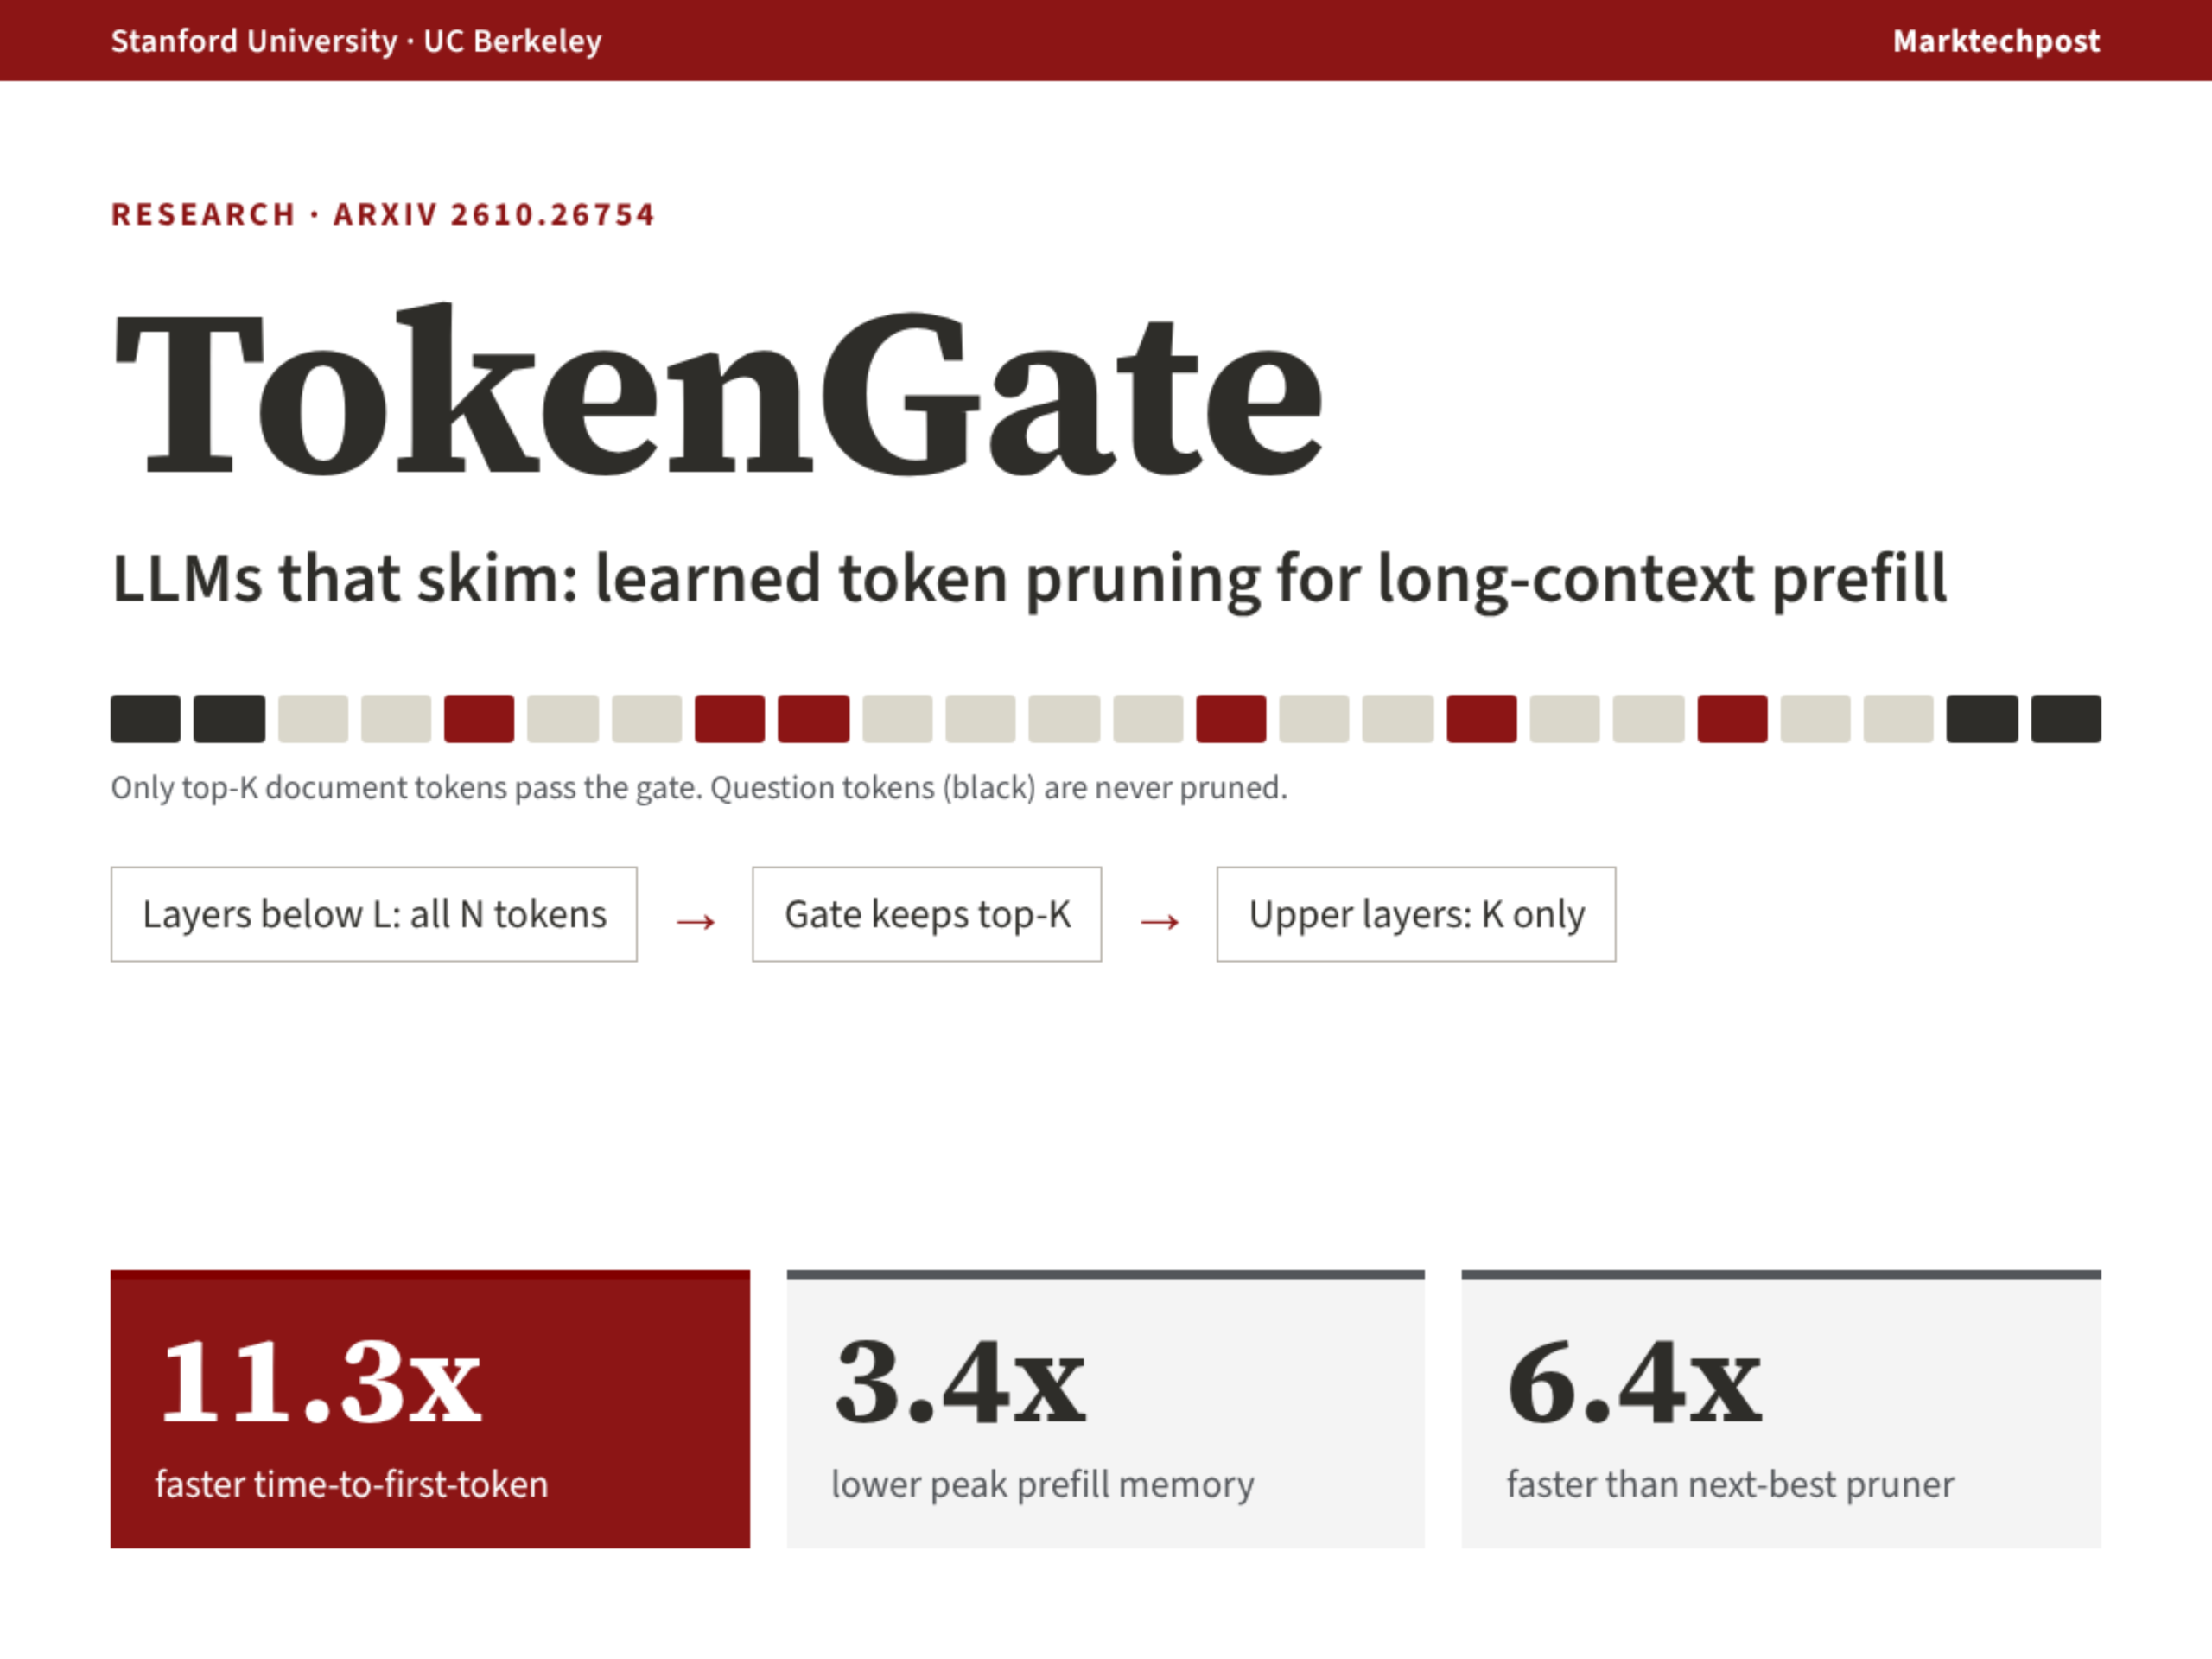
斯坦福大学与加州大学伯克利分校研究人员提出TokenGate——一种可即插即用的学习型令牌剪枝模块,适用于现有大语言模型(LLM)。该方法在不损失准确率的前提下,将长上下文预填充的首字生成时间(TTFT)加速1.4至11.3倍,峰值内存降低1.5至3.4倍。相关代码与检查点已开源。

Researchers from Stanford and UC Berkeley Introduce TokenGate: Token-Gated Attention Makes Long-Context Prefill Up to 11.3x Faster
事件进展与其他报道

Kimi发布K3.1 Pro:终端任务能力跃居榜首,仿真调试与多模态编程展现具身智能雏形

Kimi于2026年10月25日发布K3.1 Pro模型,在Terminal-Bench 4.0终端任务测试中以67.2%成功率位列第一;其自主修复仿真器错误、完成物理模拟、音频分析、3D场景构建及视频剪辑等多任务能力,指向具身智能技术路径探索。

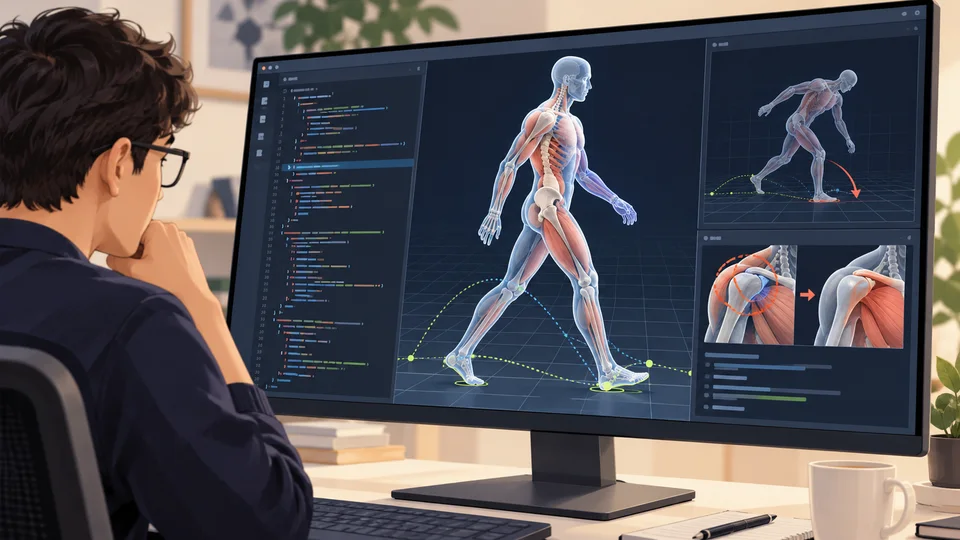
根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

推荐理由:材料基于钛媒体授权发布的实测报告,涵盖权威第三方评测数据(Artificial Analysis、Terminal-Bench 4.0等)、官方自测结果及作者多场景功能验证,聚焦K3.1 Pro在执行能力、仿真闭环、多模态编程上的实质性进步,同时明确标注性能局限与未公开信息(如Flash/Ultra尚未发布),符合事实核查与信源标注要求。

事件进展与其他报道

四分之一PR是“AI垃圾”!Linux基金会发布新报告:AI写代码快了52%,开源维护者却更累了

Linux基金会10月20日发布报告指出,生成式AI使代码编写耗时平均减少52%,但开源项目维护者估计约25%的Pull Request属低质量“AI slop”;大型项目中该比例升至31%。报告揭示效率红利未同步降低审查与治理成本,仅35%项目制定正式AI贡献政策,维护者倦怠与信任赤字凸显。

事件进展与其他报道

月之暗面发布Kimi K3.1 Pro:2.8万亿参数开源权重模型,11月4日开放权重

月之暗面于2026年10月22日前后发布Kimi K3.1 Pro,一款2.8万亿参数、1040亿激活参数的多模态MoE模型,宣称性能逼近Fable 5.1;官方承诺11月4日发布开源权重,但截至报道时权重尚未公开;独立评测显示其在智能指数、代码与网络安全基准中表现突出,但存在推理成本、本地部署可行性及营销透明度等争议。

[AINews] Kimi 3.1 Pro 104BA-2.8T: Fable-5.1-Class Open Weights narrows Closed-AI lead to 1 month... and Pro Highspeed API with 2-3× speed

推荐理由:该事件标志着当前最接近闭源前沿模型能力的开源权重模型正式进入发布倒计时,是AI开源生态关键进展;材料来源为Latent Space旗下AINews(2026年10月24日发布),内容基于对X平台、Reddit、Arena及Artificial Analysis等多方独立评测的整合,信息密度高且具时效性与交叉验证特征。

事件进展与其他报道

发布尼泊尔语-英语混合语音识别新基准与合成到真实两阶段适配框架

研究者于2026年10月24日在arXiv发布论文(编号2610.30860v1),提出首个面向自发播客场景的尼泊尔语-英语代码切换ASR基准,含13,044条真实语句(15.45小时),并设计合成到真实的两阶段适配方法:先以0.95小时多说话人TTS合成语音监督微调,再引入带脚本奖励的组相对策略优化(GRPO)。

Synthetic-to-Real Code-Switched ASR: A Spontaneous Nepali-English Podcast Benchmark

推荐理由:该工作直面低资源语言代码切换ASR中脚本混淆与切换点错误率高的核心难题,通过严格审计数据杜绝机器翻译泄露和声学循环,并公开全部验证文本、时间戳、剧集元数据及重建脚本;实验结果具统计显著性(p≤0.001),且在单语基准上验证了泛化稳定性。

事件进展与其他报道

研究揭示编码智能体基准测试中的“规范-预言机差距”问题

一篇于2026年10月24日发布在arXiv的论文指出,当前主流编码智能体基准(如SWE-Milestone)存在“规范-预言机差距”:任务自然语言描述未涵盖测试所需的关键实现细节(如常量名、模块路径、精确错误消息),导致评测实际衡量的是对上游代码的复现能力而非真正理解与推理能力。

What the Specification Did Not Say: Specification-Oracle Gaps in Test-Graded Coding-Agent Benchmarks

推荐理由:该研究首次形式化定义该类偏差,构建覆盖五种语言的静态审计工具(精度89.2%,召回率92.9%),并在SWE-Milestone中实证发现25个里程碑任务含不可推断的隐式依赖,显著拉高失败率(80.6% vs 48.4%),揭示当前排行榜可能系统性偏爱‘抄名称’型智能体;成果已开源审计工具与修正资源,具方法论与实践双重价值。

事件进展与其他报道

Amazon Polly Generative引擎重大升级:新增14种语音、首次支持印地语与芬兰语生成式语音,零代码迁移

Amazon Polly Generative引擎完成重大升级,显著提升语音自然度、准确性与情感表达能力,支持低延迟流式合成;新增14种生成式语音覆盖9个地区,首次实现印地语(Arjun、Kiara)和芬兰语(Suvi)的生成式语音通用可用;全部升级为无缝替换式更新,无需修改API调用或代码。

事件进展与其他报道

Claude Mods:注意力接口的首次实践,人类可编程的代理交互层

Claude Mods 是 Anthropic 推出的 Claude Code 可编程插件系统,代表‘注意力接口’(Attention Interface)的早期形态——它将传统面向机器的代理运行时框架(agent harness),转向面向人类注意力的可定制交互层。用户可通过 TypeScript/JS 编写 Mods,或用自然语言让 Claude 自动生成,从而决定何时被中断、看到什么内容、需做哪些决策。

事件进展与其他报道