01 / OVERVIEW
FLUX 3 是什么?
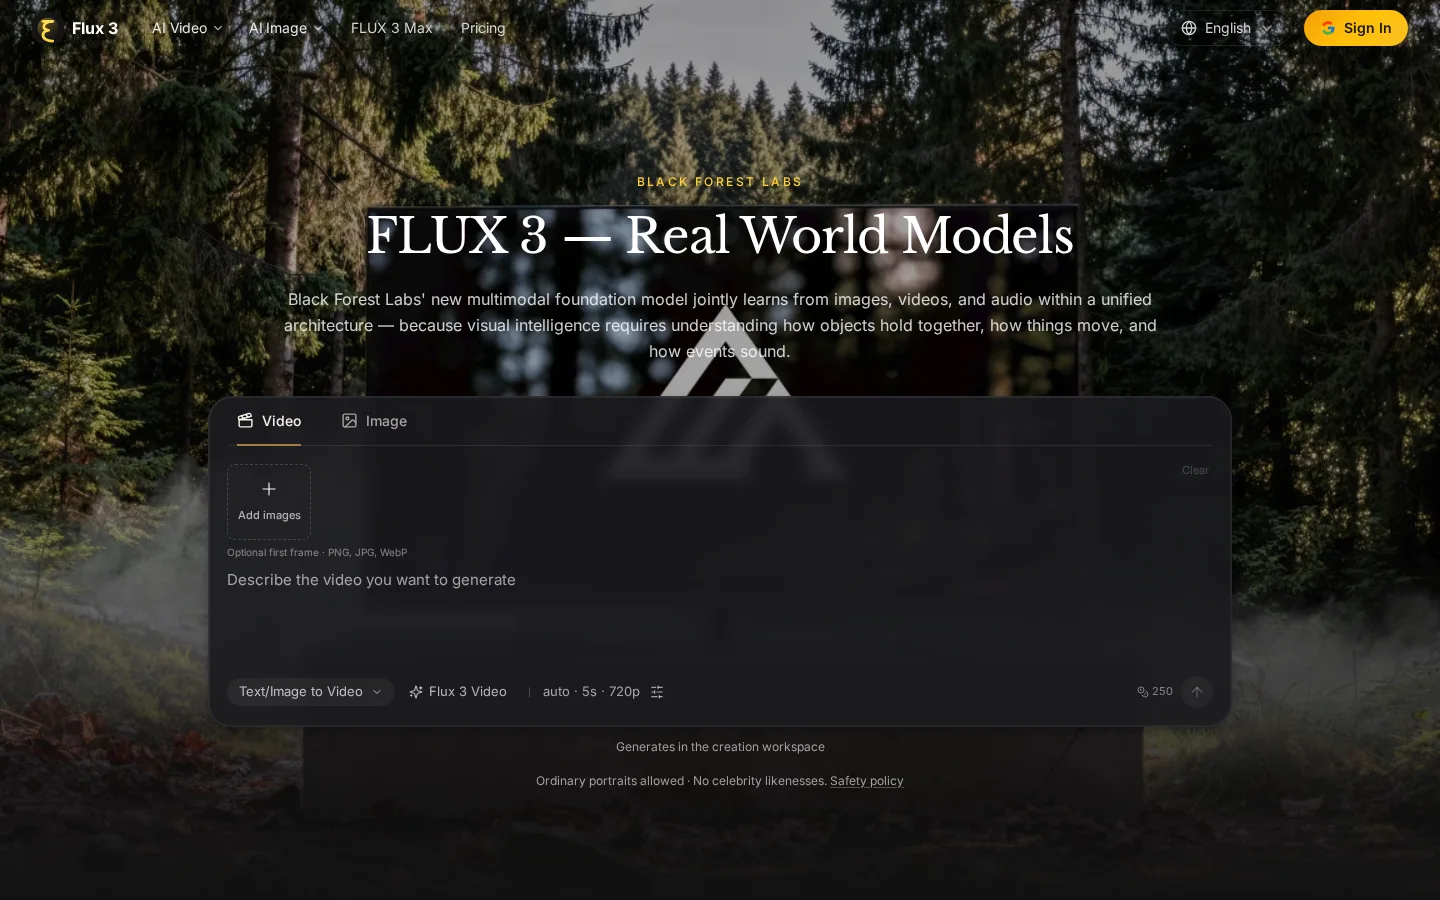
FLUX 3 是 Black Forest Labs 研发的新一代多模态基础模型,其核心使命是发展‘真实世界视觉智能’:模型需能感知、预测并作用于物理与数字环境。它基于 Self-Flow 架构,首次实现图像、视频、音频三模态在统一模型中联合训练与对齐,使生成内容具备跨模态一致性——例如画面中的物体运动遵循物理规律,伴随声音准确反映事件性质,多镜头叙事中角色外观与行为保持连贯。当前视频生成功能已开放早期访问,支持原生同步音频生成、多镜头链式编排及参考驱动编辑,为创作者、营销团队与机器人研发者提供真正协同的智能创作伙伴。
02 / CAPABILITIES
主要功能
支持文本到视频、图像到视频动画、视频到视频参考迁移、生成式音视频续写及关键帧控制视频生成,全部具备原生同步音频(最长20秒)
可将多个独立生成片段链式组合为长时多镜头序列,并通过视觉参考确保角色、风格与上下文在全叙事中高度一致
03 / AUDIENCE & USE CASES
适用场景与人群
创作者与电影制作人、市场营销与视觉设计团队、物理AI及机器人研发团队
- 生成带原生音频的影视级短视频(最长20秒),支持多语言对话与音效设计
- 基于图像或视频片段进行风格迁移与角色一致性续写,构建多镜头叙事序列
- 为物理AI与机器人领域提供动作预测能力,通过FLUX-mimic模型实现灵巧操作微调
输入
文本提示;图像、视频片段、关键帧等多模态参考输入
输出
带同步原生音频的视频(最长20秒)、多镜头链式视频序列、多语言对话与音效、风格化图像与 typography 设计、动作预测结果
常见问题
FLUX 3 现在可以使用吗?
FLUX 3 Video 已开放早期访问;FLUX 3 Image 尚未上线,预计数周后开启早期访问
FLUX 3 Video 能生成哪些内容?
支持文本生成视频、图像转视频动画、视频转视频参考迁移、生成式音视频续写及关键帧控制视频,全部带同步原生音频
GETTING STARTED
如何使用
- 01
访问 flux3.dev 进入平台
- 02
选择 FLUX 3 Video 早期访问功能
- 03
输入文本提示,或上传图像/视频作为参考素材
- 04
生成带同步原生音频的视频,支持多镜头链式编排
SOURCES
官网与资料来源
资料更新于 2026-10-29
RELATED COLLECTIONS
相关专题
NEWS REPORTS