FLUX 3とは?
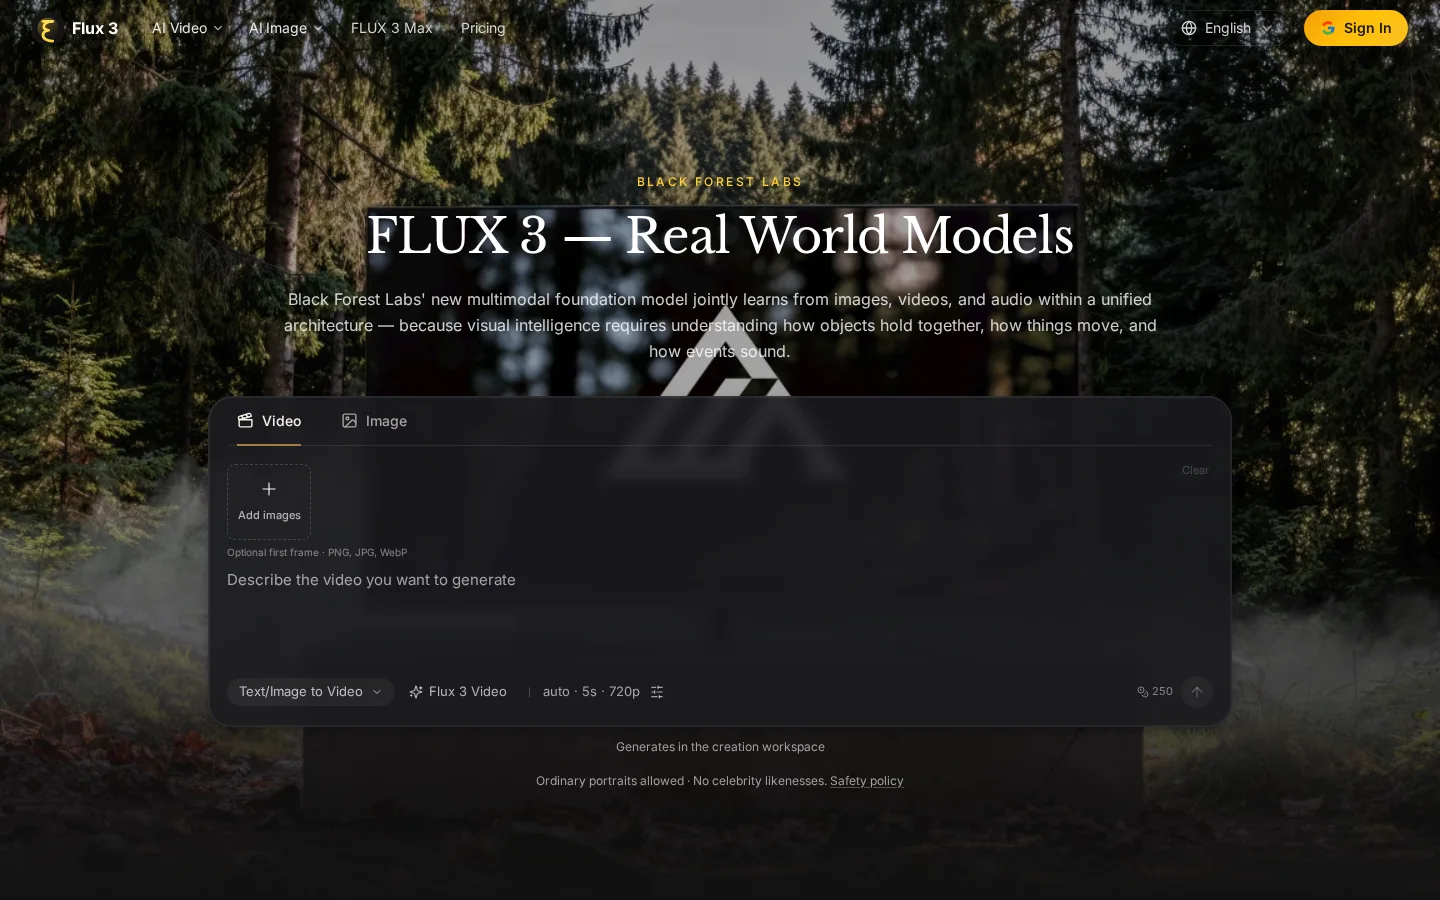
FLUX 3は、Black Forest Labsが開発した新世代のマルチモーダル基礎モデルで、その核心的な使命は「現実世界の視覚インテリジェンス」の実現です。モデルは物理環境およびデジタル環境を感知・予測・作用できる能力を備えています。Self-Flowアーキテクチャに基づき、画像・動画・音声の三モーダルを初めて統一されたモデル内で同時に学習・整合させることで、生成コンテンツに跨モーダルな一貫性を実現しました。たとえば、画面内の物体の動きが物理法則に従い、伴う音声が事象の性質を正確に反映し、多カットの物語においてもキャラクターの外見や行動が連続性を保つといった具合です。現在、動画生成機能は早期アクセスが可能で、ネイティブな同期音声の生成、多カットのチェーン編成、参照駆動による編集をサポートしており、クリエイターやマーケティングチーム、ロボット開発者にとって真に協調的な知能型創作パートナーとなっています。
主な機能
テキストから動画、画像から動画アニメーション、動画から動画への参照転送、生成型音声・映像の継続生成、およびキーフレームによる動画生成をサポートし、いずれもネイティブな同期音声(最長20秒)を備えています。
複数の独立した生成セグメントをチェーン状に連結して長時間の多カットシーケンスに組み立てることができ、視覚的参照を通じてキャラクター・スタイル・文脈が物語全体で高い一貫性を保つよう確保します。
用途と対象者
クリエイターや映画製作者、マーケティング・ビジュアルデザインチーム、さらには物理AIやロボット開発チームなど、幅広い分野で活用できます。
- ネイティブ音声付きの映画級ショート動画(最長20秒)を生成し、多言語対応の会話や効果音設計にも対応します。
- 画像や動画クリップを基にスタイル転送とキャラクターの一貫性を保った継続描写を行い、マルチショットの物語シーケンスを構築します
- 物理AIおよびロボティクス分野において動作予測機能を提供し、FLUX-mimicモデルにより巧みな操作の微調整を実現します
テキストプロンプト、画像・動画クリップ・キーフレームなどのマルチモーダルな参照入力に対応しています。
同期されたネイティブ音声付きの動画(最長20秒)、多カットのチェーン状動画シーケンス、多言語対応の会話や効果音、スタイル化された画像やタイポグラフィデザイン、動作予測結果などを生成できます。
よくある質問
FLUX 3 は現在ご利用いただけますか?
FLUX 3 の動画は早期アクセスが開始されています。一方、FLUX 3 の画像はまだリリースされておらず、数週間後に早期アクセスが開始される予定です。
FLUX 3 Video ではどのようなコンテンツが生成できますか?
テキストから動画の生成、画像から動画へのアニメーション変換、動画から動画へのリファレンス転送、生成型音声・映像の継続生成、およびキーフレームによる動画の制御をサポートしており、いずれも同期されたネイティブオーディオを備えています。
使い方
- 01
flux3.dev にアクセスしてプラットフォームへ進みます
- 02
FLUX 3 Video の早期アクセス機能を選択してください
- 03
テキストプロンプトを入力するか、参考素材として画像や動画をアップロードしてください
- 04
同期されたネイティブオーディオ付きの動画を生成し、マルチショットのチェーン編集にも対応します
公式サイトと情報源
情報更新日 2026-10-29