Show HN:LLM-cost-watch – Claudeに、あなたのLLM請求額が急増した理由を尋ねてみましょう
記事のURL:https://github.com/rohith0707/llm-cost-watch コメントのURL:https://news.ycombinator.com/item?id=50415785 ポイント:1 # コメント:0
見出し・要約・本文から、情報のつながりを探します。
記事のURL:https://github.com/rohith0707/llm-cost-watch コメントのURL:https://news.ycombinator.com/item?id=50415785 ポイント:1 # コメント:0
GitHubは2026年10月28日、Copilot Fusionの正式版を公開し、同時に実験的なローカルモデルルーティング機能も導入しました。この機能により、Windowsデバイス上でMAI Code 1.1 Flashなどのローカルモデルを自動的に呼び出すことができ、VS Code、CLI、およびCopilot Appにおいてインテリジェントなルーティングが有効化されます。本システムは、Standard/High/Maxの三段階の努力レベルに基づき、クラウドモデル(OpenAI、Anthropic、Googleなど)を自動的に選択・組み合わせてタスクを実行します。コーディング評価においては、Claude Codeに近い性能を実現しつつ、コストは半減しています。
arXiv:2610.38069v1 公開タイプ:新規 要旨:短時間フーリエ変換(STFT)は、長時間信号の短い時間窓に対するフーリエ変換を計算し、周波数が時間とともにどのように変化するかを特徴づける手法である。フーリエ変換アルゴリズム、特に高速フーリエ変換(FFT)アルゴリズムは、並列計算を活用するために十分に発展しているが、短時間フーリエ変換の並列アルゴリズムの性能に関する研究はまだ限られている。本研究では、FFTベースのアルゴリズムと準並列型のフィードフォワードアルゴリズムという二つの並列短時間フーリエ変換アルゴリズムを実装し、相互に比較・分析した。その結果、並行度が低い環境下では準並列型アルゴリズムの方が実行時間が短いものの、…
arXiv:2610.38355v1 発表タイプ:新規 要旨:KVキャッシュの再利用は大規模言語モデルのサービスを加速させるが、既存のシステムではホストのDRAMとNVMe SSDを階層的なヒエラルキーとして管理しており、DRAMが中間キャッシュとして機能している。しかし、実際の大規模言語モデルのワークロードは、この階層構造の二つの前提をいずれも破っている。第一に、バイモーダルな再利用によりDRAMの時間的フィルタリングが無効化される。というのも、ワークロードは長い再利用距離を持つワンショットブロックか、DRAM容量を超える数ギガバイト規模のエージェントセッションによって支配されており、その結果SSDが重要な読み取りパスに置かれているからである。第二に、DRAMによるステージングと、排出現象に基づくレイアウトがSSDの復元処理をボトルネックにしている。進行中のプレフィックスのためにホストのステージングバッファを保持すると、負荷下で競合が生じてプリフェッチが中断されてしまう一方で、段階的な排出現象によってセッション内のブロックがSSD全体に散らばり、大規模なシーケンシャルリードが妨げられる。我々は…
arXiv:2610.37676v1 公表タイプ:新規 要旨:自動解釈可能性は、スパースオートエンコーダー(SAE)の特徴について、評価例に対してその特徴がどの位置で活性化するかをトークンごとに予測させたり、マークされたトークンがその特徴に適合しているかどうかを判定させたりすることで、解説を評価します。我々は、評価データの標準的な処理パイプラインのみを用いても、解説を読まないままスコアリングが可能であることを示しました。Neuronpediaに保存されているGPT-2 smallモデルのランダムな500個の特徴に対するファジング実行において、活性化した例の91.3%が中心トークン上でピークを持つように切り取られており、さらに中心トークンがマークされていれば「はい」と判定するルールは、パイプラインのコードから再構築されたマークに基づいて計算した結果、保存済みのLLMスコアラーの0.838に対し、バランスのとれた精度0.979を達成しています。一方、マーク数のみを参照するルールでは0.969を記録しました。T
消費者向け人工知能アシスタントを開発するWabi Inc.は本日、シリーズAラウンドで5,500万ドルの資金調達を完了したと発表しました。このラウンドはIVPがリードし、Amazon Alexa Fund、Andreessen Horowitz、Forerunnerから出資を受けました。さらに、Salesforce Inc.のCEOであるマーク・ベニオフ氏やShopify Inc.のCEOであるトビ・リュトケ氏ら、複数のエンジェル投資家も参加しています。記事「Wabi、消費者向けAIアシスタントで5,500万ドルを調達」は、SiliconANGLEに最初に掲載されました。
逆転だ!Wisprが自社のディクテーションアプリに会議メモ機能を追加したのに続き、グラノラも会議用メモ作成ツールにディクテーション機能を導入。音声AI戦争がますます興味深い展開を見せている。

GitHubはUniverse 2026において、Copilot Fusionというインテリジェントなオーケストレーション層を公開しました。この層は、OpenAI、Anthropic、Googleなどのモデルを自動的にルーティングし組み合わせてコーディングタスクを実行できるため、開発者は手動でモデルを選択する必要がありません。既存の自動モデル選択技術と、9月に研究としてプレビューされたProject HydraFusionの多モデル編成機能を統合しており、モデルセレクターを有効にすると、システムはタスクの複雑さに応じて単一モデル、カスケード、レビューといった実行モードを自動的に採用します。

作業は必ずしも単一のリポジトリやセッションに収まるわけではありません。ある機能が複数のリポジトリにまたがることもあります。ローンチ計画では、リポジトリに手を触れることなく、仕様書やデザイン、アセットを取り込むことも可能です… この記事「GitHub Copilot アプリ、Universe のリリース」は、The GitHub Blog に最初に掲載されました。
arXiv:2610.36709v1 発表タイプ:新規 要旨:推論型言語モデルは、長い思考の連鎖を書き出すことで数学問題に解答し、問題ごとに多数の連鎖をサンプリングして多数決を取ることで、生成テキスト量が大幅に増えるというコストを伴いながら精度を向上させている。このコストを削減する一般的な手法として、モデルが各トークンを生成する際の信頼度に基づいて各連鎖をスコアリングする方法がある。ここでトークンとは、単語または単語の一部を指す。この手法では、2048トークンの移動平均を計算し、その平均値が最も低い連鎖を保持または停止する。私たちは、トークンごとに記録された信頼度を、音声やラジオにおける信号と同様の意味で捉え、スペクトル解析や急激な変化を検出する統計検定などの標準的な信号処理手法を用いてこの手法を評価した。私たちは、以下のデータセットから500問の各問題について16本の連鎖をサンプリングした。
ケイトリン・レスとアンジェラ・ジ앙がLatent Spaceに登場し、Claudeプラットフォームの背後にある技術について解説します。Opus 5.5のリリース、モデルの「脳」とエージェントの「手」の分離、APIのスケーリング、そして信頼性の高いマネージドエージェントの構築について語ります。新たな導入部分では……
NVIDIA RTX Sparkは、スリムなノートPCやコンパクトなデスクトップでAI開発、クリエイション、ゲームを実現する新しいWindows PCプラットフォームです。NVIDIA Blackwell RTXを搭載しています…
Mozillaは2026年10月27日、FirefoxのAIブラウジング機能「Smart Window」をアップデートし、ユーザーが現在開いているタブに基づいたスマートなフォーム入力機能を新たに搭載しました。これにより、LinkedInやポートフォリオサイトなどのウェブページから情報を抽出し、求人応募書などの複数項目を自動で入力することが可能になります。
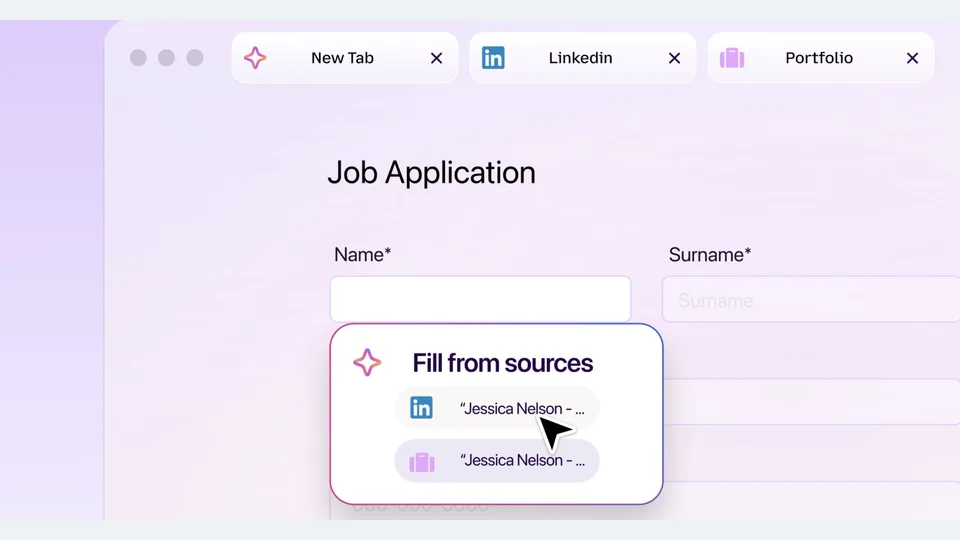
注目する理由:このアップデートは、Firefoxブラウザーにおける最近のAI機能の進化において重要な一歩です。The Vergeが報じており、公開日(2026年10月27日)も明示されています。内容は具体的な操作ロジックや利用シーンに焦点を当て、情報要素は十分に網羅され、出典も明確です。ただし、技術的な実装詳細やデータ処理方法、プライバシー方針については明らかにされておらず、また、この機能が全ユーザーへ展開されているのか、特定のテストチャンネルに限定されているのかも示されていません。
今日、世界では5,700万人が認知症を抱えています。彼らを支援しようとする研究者たちにとって、障壁となっているのは努力不足ではなく、データが過剰であり、それを統合する専門家が不足していること、そして疾患の進行に追いつかないほどの発見のペースです。[…]における生物医学研究とAIに関するコンソーシアムは…
Mirendilは、1,000万トークンのコンテキストウィンドウでゼロから事前学習された初のモデルであるFern 0.1をリリースしました。同モデルはエージェント型AIの研究開発を対象としており、1,000万トークン規模でのRULERシングルニードルテストでは100%のスコアを獲得していますが、エージェント型コーディングにおいては最先端モデルには及ばない結果となっています。この記事「Mirendil、1,000万トークンのコンテキストを持つ初のモデルFern 0.1を公開」は、MarkTechPostに最初に掲載されました。

2026年の長沙・1024プログラマーの日に開催されたCEIC消費電子イノベーション大会とCSDNは、深圳で開発者向けの本格的な技術の祭典を共同で実現しました。CEIC組織委員会の常務副主任である楊涛氏がインタビューで述べたように、「消費電子分野におけるあらゆる体験の革新は、結局のところ私たちプログラマーが打ち込むコードによって生み出されるのです。」現在の技術の転換点において、単なる手書きのコードから、エージェントや豊富な端末側APを活用する時代へと進んでいます…

モデルクレジットがフェスティバルのプロモーションやキャリアスタイルのパッケージに登場しています。不透明なマークアップで成り立っていた小規模な再販業者は、品質への疑念や規制強化、そして資金力のある競合企業との競争に直面しています。一方、安定した中間業者は、秘密裏な値下げではなく、ルーティング、信頼性、統合に対して料金を請求するでしょう。
Baiduは、MITライセンスの3B規模のOCRモデルであるUnlimited OCR 2をリリースし、1回のリクエストで数百ページに及ぶ文書を解析できます。同モデルのSR-SWAアテンションにより、各ステップのデコーディングコストはほぼ一定に保たれ、MarathonDocBenchでは77.1点を獲得しています。この記事「Baidu、数百ページの文書解析向けUnlimited OCR 2をオープンソース化」は、MarkTechPostに最初に掲載されました。

arXiv:2610.34436v1 発表タイプ:新規 要旨:ループ型言語モデルは、各トークンに対して層のブロックを$R$回実行するため、そのキーバリューキャッシュ(KVキャッシュ)には各再帰層ごとに$R$個の平面が格納され、自己予測的デコーディング(一部のループで予備的に推論し、残りの$R$すべてで検証する手法)ではそれらすべてが読み込まれる。我々は、プレフィックスのキーとバリューが影響を及ぼすのは後半に集中していることを発見した。同程度の摂動サイズにおいて、ループ25〜32はループ2〜9に比べてそれぞれ$e^{15.0}$倍(Huginn-0125)および$e^{12.8}$倍(Raven-Llama)も敏感であり、各ループごとの平面数は0.88および0.81という比率で最終的な平面へと幾何級数的に近づいていく。そして、最も深い平面単独で十分かどうかは、後半の平面がどれほど成熟しているかに依存する。Ravenでは、それを保存するだけでbf16からfp32への変更と区別できない一方、Huginnでは、全体の誤差の74%をわずか1%の位置が占めている。これをRIPEに展開すると、最も深い…