01 / OVERVIEW
Image to Text (Using AI) 是什么?
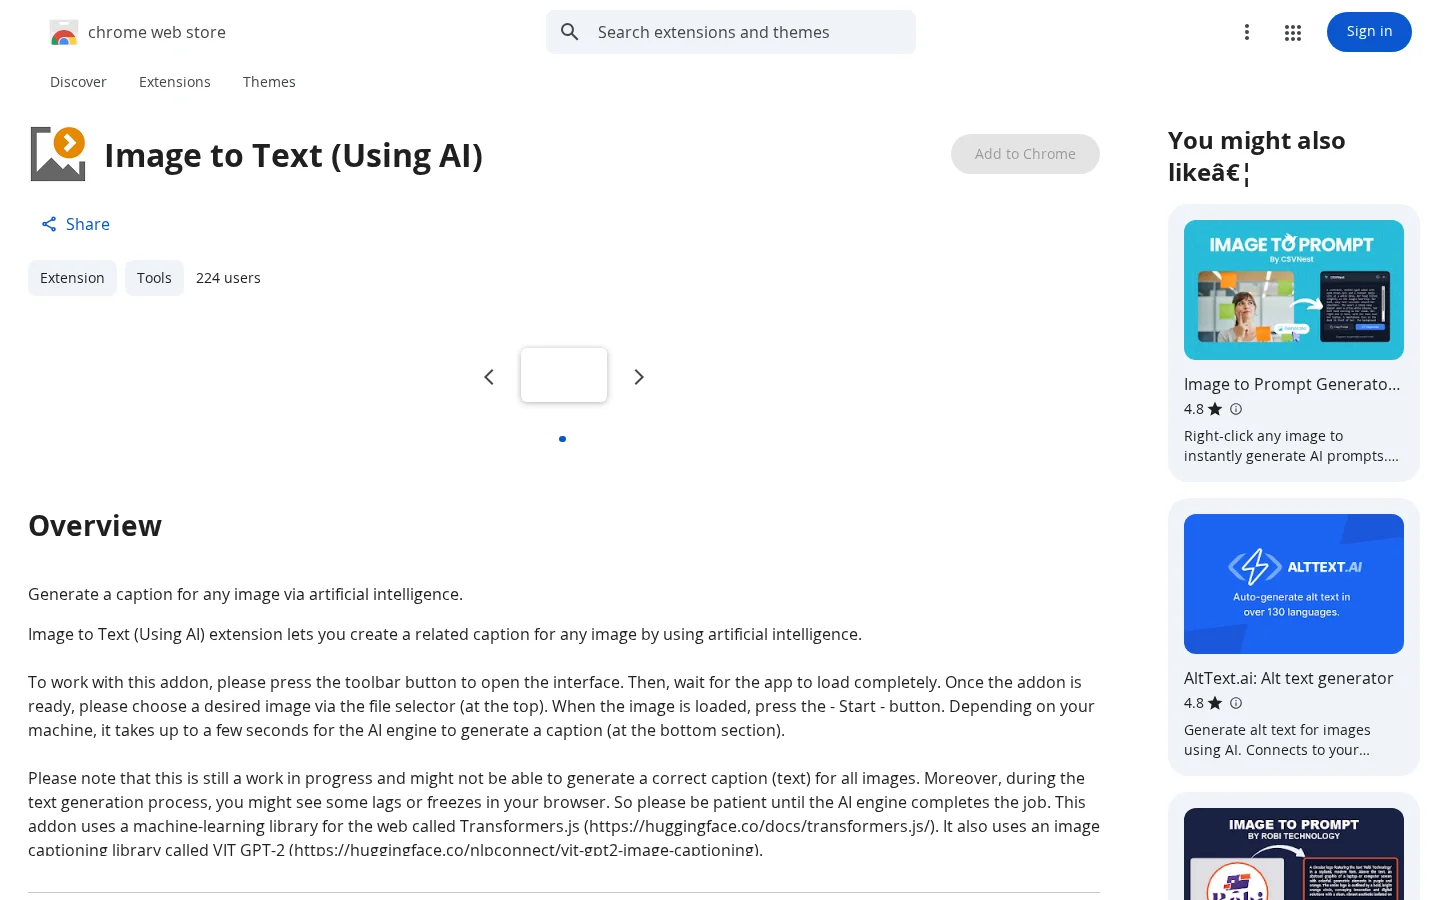
Image to Text (Using AI) 扩展利用前沿的视觉-语言模型 VIT GPT-2 与 Transformers.js 库,在用户浏览器中实现端侧图像理解;首次启用时需下载约1GB训练数据,后续使用完全离线;操作流程简洁:点击工具栏按钮打开界面 → 通过顶部文件选择器上传图片 → 点击“Start”按钮 → 数秒内于底部生成文字描述。该工具目前仍处于持续优化阶段,对部分复杂图像的描述准确性可能存在局限,且生成过程中偶有浏览器响应延迟现象,建议耐心等待完成。
02 / CAPABILITIES
主要功能
支持完全离线运行:下载完约1GB模型数据后,无需网络连接即可生成图像描述;
采用 VIT GPT-2 图像描述模型与 Transformers.js 前端机器学习库,实现浏览器内端到端AI推理。
03 / AUDIENCE & USE CASES
适用场景与人群
需要快速为图片生成描述性文字的普通用户、网页内容编辑者、无障碍开发初学者
- 为任意图片生成AI描述性标题(caption)
- 离线运行图像到文本的本地化处理
- 辅助生成网页图片的替代文本(alt text)初稿
输入
本地上传的单张图片文件
输出
一段由AI生成的自然语言标题(caption),位于界面底部输出区
常见问题
首次使用为何加载缓慢?
因插件需下载约1GB的完整训练数据至浏览器本地,首次启动需较长时间,请耐心等待
是否需要联网才能运行?
仅首次下载训练数据时需联网;下载完成后,插件可完全离线运行,无需互联网连接
GETTING STARTED
如何使用
- 01
点击浏览器工具栏按钮打开插件界面
- 02
等待插件完全加载(首次使用需下载约1GB训练数据)
- 03
通过顶部文件选择器上传目标图片
- 04
点击“Start”按钮,等待AI在底部生成标题(耗时数秒)
SOURCES
官网与资料来源
资料更新于 2026-10-30
RELATED COLLECTIONS
相关专题
NEWS REPORTS


