본문으로 건너뛰기
AI NEWS JOURNAL
FOLLOW THE THREAD

AI 视频

주제별로 새로운 사실과 후속 변화를 따라갑니다.

발행 시간순

레이쥔, 샤오미 로봇의 가사 수행 영상 공개, Xiaomi-Robotics-1로 장거리 작업 지원 샤오미 창립자 레이쥔은 최근 웨이보에 영상을 올려 샤오미 로봇의 가정 환경에서의 최신 테스트 진행 상황을 보여줬다. 이 로봇은 샤오미 청년 아파트에서 시범 운영 중이며, 쓰레기 청소, 물건 분류 및 정리 등 가사를 수행할 수 있고, 호박씨 껍질을 치우거나 놓인 충전기를 정리하는 모습이 주목을 받았다. 해당 로봇은 Xiaomi-Robotics-1 신체 기반 모델과 완전 자동 실행 시스템을 기반으로 하며, 실측 결과 30분 이상 연속 작동했고 3개의 방을 커버해 50개 이상의 장거리 작업을 완료했다. 방금 전 0

샤오미 창립자 레이쥔은 최근 영상에서 청년 아파트에서 진행 중인 샤오미 로봇의 최신 테스트 성과를 공개했다. 해당 로봇은 쓰레기 수거, 물품 분류 및 정리 등 가사 작업을 수행할 수 있으며, 실제 테스트 결과 30분 이상 연속 작동해 세 개의 방을 모두 커버하고 50가지 이상의 과제를 완수했다. 영상 속 로봇은 책상 위 쓰레기 치우기, 흩어진 물품 정리, 방 재점검 등의 작업을 수행하며, 이는 구체적 지능이 단일 기능에서 다방향·장시간 가사 작업의 폐쇄 루프로 발전했음을 의미하며, 가정 환경 적용을 위한 데이터 검증을 제공한다.

메타, 가상 옷장과 AI 시착을 지원하는 AI 패션 앱 스타일 스케치를 조용히 출시

메타는 AI 패션 앱 스타일 스케치를 출시했으며, 기존 의류를 디지털화하고 AI를 통해 개인 맞춤형 코디를 생성할 수 있습니다. 이 앱은 인도네시아, 싱가포르, 태국의 iOS 및 안드로이드 플랫폼에서 이미 출시되었으며, 아직 전 세계적인 확대 계획은 없습니다. 또한 인스타그램과 연동해 사진을 기반으로 자동으로 가상 옷장을 구성할 수 있으며, 사진 촬영, 짧은 동영상 또는 갤러리에서 수동으로 의상을 추가할 수도 있고, 옷장과 개인 스타일을 결합해 매칭된 코디를 추천합니다.

QQ20261030-090653.jpg
진행 상황 및 관련 보도

렉스 프리드먼 팟캐스트 정독|AI의 충격 속에서 수학자는 과연 무엇을 남겼는가?

렉스 프리드먼의 이번 에피소드는 총 13개의 주제로 나뉘어 있습니다. 게스트로는 세 명이 참여했는데, 워싱턴 대학교에서 유체역학을 연구하는 스티븐 브런턴, MIT에서 이론 컴퓨터 과학을 전공하는 앵커르 모이라, 그리고 러트거스 대학교에서 정수론과 리인을 연구하는 알렉스 콘토로비치입니다. 영상에서는 나비에-스톡스 방정식, 리만 가설, 그리고 계산 복잡성 이론에 대해 논의했으며, 그 배경에는 최근 몇 주 사이에 AI가 이들 분야의 오랜 난제들을 연이어 해결했다고 선언한 사건이 있었습니다. 세 명의 수학자들은 각자의 전문 분야에서 출발해 이를 하나하나 분석했습니다...

Lex Fridman播客精读|AI冲击下,数学家还剩下什么?
진행 상황 및 관련 보도

Manus가 방금 조용히 자신의 2.0 선언을 발표했습니다

10월 26일, Manus의 공동창업자이자 제품 파트너인 장타오(온라인 닉네임 HideCloud)는 최근 자신의 공식 계정 ‘잠운사유’에 ‘Manus로 Manus를 개조하다’라는 제목의 장문을 게시했다. 글의 서두에는 그에게 깊은 인상을 남긴 한 장면이 등장한다. 그는 엔지니어에게 몇 가지 요구사항과 버그를 전달한 뒤 잠시 후 진행 상황을 확인하니, 상대방의 컴퓨터에는 Codex와 Manus의 세션이 줄지어 열려 있었다. 무작위로 하나를 클릭해 보니, 입력된 내용은 바로 그가 방금 Slack에서 올린 요구사항 원문 그대로였고, 단 한 글자도 수정되지 않았다. 더욱 놀라운 점은, 해당 엔지니어가 당시 동시에 십여 개에서 이십여 개의 요구사항을 처리하고 있었다는 사실이다. 오늘날 Manus에서는 이러한 상황이 이미 일상이 되었다. 이 글은 정보량이 매우 많으며, 특히 기억해둘 만한 몇 가지 사항이 있다. Manus 내부에는 ‘Manus-mono’라는 통합 코드 입구가 마련되어 있고, AI가 이해할 수 있도록 작성된 설명서까지 함께 제공되어 있어, AI가 리포지토리 간의 전체적인 흐름을 파악할 수 있게 된다. 하나의 요구사항만으로도 한 사람이 모든 플랫폼의 구현을 완료할 수 있다. 모바일팀은 항상 단 7명으로 구성되어 있으며, 동시에 두 개의 제품과 네 개의 앱을 담당하고 있는데, 진행 상황은 웹버전과 거의 동기화된다. 모든 제품 매니저들이 Manus에 코드를 제출했고, 그중 약 절반은 스스로 요구사항을 완전히 개발해 서비스에 적용하기도 한다. 일부 매니저가 제출한 요구사항은 문서에서 벗어나 이미 영상으로 구현되기도 한다. 마케팅팀에는 ‘디지털 동료’가 생겨, 스스로 업무를 배치하고 프로젝트 진행 상황을 적극적으로 알리며, 팀 간 협업을 통해 기능 세부사항까지 명확히 파악하는 역할을 수행한다. 9월에는 회사의 AI 관련 지출이 1인당 평균 1만 달러를 넘어섰고, 소수의 인원은 한 달에 7~8만 달러를 사용하기도 했다. 장타오는 이에 대해 별도의 섹션을 할애해 외부의 의혹에 답했다. 글이 발표된 시점 또한 매우 미묘하다. 9월 말에는 Manus가 2.0 버전과 개인형 인공지능 애플리케이션 Cue를 출시했고, 10월 초에는 모회사인 ‘나비효과’가 5억 달러가 넘는 신규 투자 유치를 완료하며, 동시에 베이징에서 17개의 채용 공고를 내놓았다. 이러한 시점에서 볼 때, 이 글은 오히려 Manus 팀이 2.0 시대에 진입했음을 알리는 선언과도 같다. 여기서는 조직이 AI를 어떻게 활용해 발전해 나가는지를 다루고 있지만, 그 이면에는 이 회사의 제품 방향, 비용 체계, 그리고 인재 채용 기준까지 드러나 있다. 01 Manus 자체가 바로 2.0의 모델룸이다. 만약 당신이 글 속의 내부 실천 사례들과 Manus 2.0의 기능 목록을 비교해 본다면

진행 상황 및 관련 보도

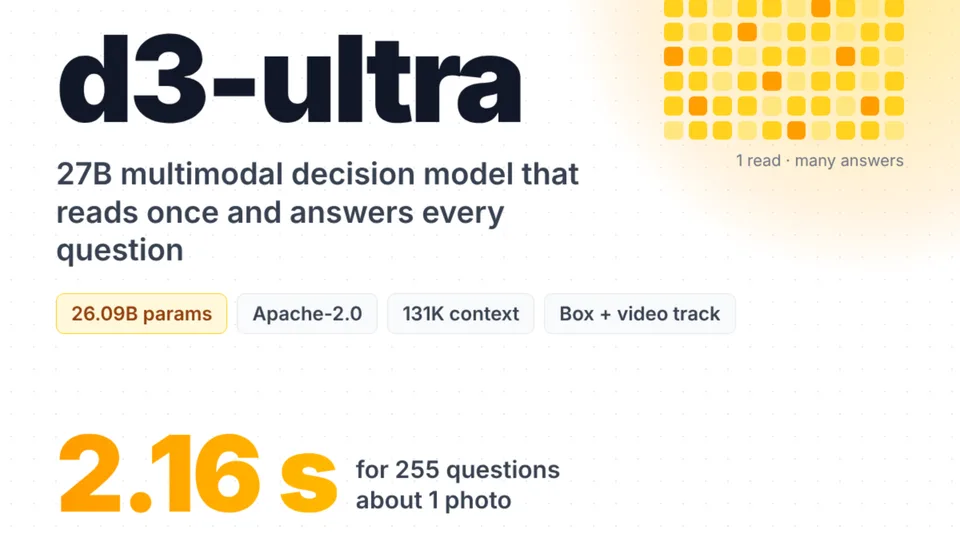
vLLM 시맨틱 라우터, d3-ultra 출시: 27B 규모의 오픈형 멀티모달 의사결정 모델

vLLM 시맨틱 라우터가 27B 규모의 오픈 웨이트 멀티모달 의사결정 모델인 d3-ultra를 출시했습니다. 이 모델은 텍스트, 이미지 및 비디오를 한 번에 처리한 뒤 모든 답변에 대한 확률을 반환하며, 팀의 SR-Text 테스트에서 87.2점을 기록했습니다. 해당 게시물 “vLLM 시맨틱 라우터, 27B 규모의 오픈 멀티모달 의사결정 모델 d3-ultra 출시”는 MarkTechPost에 처음 게재되었습니다.

新闻源配图 · MarkTechPost
진행 상황 및 관련 보도

PhaseBreak: 무단 이미지-비디오 애니메이션에 대한 선제적 시간적 보호

arXiv:2610.33070v1 발표 유형: 신규 초록: 이미지-비디오(I2V) 확산 모델은 단일 인물 사진이나 이미지를 애니메이션화하여, 주체의 허가 없이 공유된 이미지를 움직임 합성에 재사용할 수 있도록 합니다. 우리는 이러한 용도에 대비한 선제적 시각적 보호를 연구합니다: 이미지가 공개되기 전에 소유자는 공유 워크플로우는 유지하되 하위 단계의 움직임 생성을 방해하는 제한된 변동을 적용합니다. 기존의 스펙트럼 교란 목적은 시간적 표현을 전반적으로 감쇠시키므로, 미세하거나 공간적으로 국부화된 움직임에 대해서는 제한된 통제만 가능합니다. 우리의 핵심 아이디어는 생성된 동작이 시간적 특징의 강도뿐만 아니라, 특징 이벤트가 발생하는 순서에도 의존한다는 점입니다. 우리는 PhaseBreak라는 화이트박스 스펙트럼 리타이밍 보호 기법을 제안합니다.

진행 상황 및 관련 보도

v0.43.0

## 변경된 내용 * model_prefetch: https://github.com/Comfy-Org/ComfyUI/pull/17178에서 @rattus128이 모든 그래프 정리 작업을 동기화했습니다 * https://github.com/Comfy-Org/ComfyUI/pull/17172에서 @kijai가 MOSS-image에 로프 스케일링 지원 기능을 추가했습니다 * [파트너 노드] https://github.com/Comfy-Org/ComfyUI/pull/16943에서 @dante01yoon이 API 노드의 파트너 노드 로그인 토큰을 갱신했습니다 * [파트너 노드] feat(HeyGen): https://github.com/Comfy-Org/ComfyUI/pull/17043에서 @bigcat88이 HeyGen Voice 즉석 클론 및 텍스트 음성 변환 기능을 추가했습니다 * [파트너 노드] feat(ClarityAI): https://github.com/Comfy-Org/ComfyUI/pull/17192에서 @bigcat88이 Crystal Video Upscaler 노드를 추가했습니다 * [파트너 노드] feat(BFL): https://github.com/Comfy-Org/ComfyUI/pull/17200에서 @bigcat88이 FLUX 3 비디오 노드에 2K/4K 해상도 옵션을 추가했습니다 * MOSS-image 지원

진행 상황 및 관련 보도

Kimi, K3.1 Pro를 출시하며 용량 증가와 가격 인하로 Opus 5.5에 도전합니다

작성자|우항위안 편집자|징위 10월 23일 오전, Kimi 공식 계정은 X와 비디오 계정을 통해 24초짜리 영상을 게시했다. 화면에는 레트로 스타일의 구형 컴퓨터가 등장하고, 화면에는 Kimi Code가 실행 중이며, 터미널에는 Three.js 코드가 줄줄이 출력되며 복잡한 3D 장면이 생성되고 있었다. 눈썰미가 좋은 네티즌들은 곧 왼쪽 상단의 모델 표시줄에서 답을 찾아냈다—「Model: Kimi K3.1」. Kimi 공식이 공개한 K3.1 사전 홍보 영상|출처: X @Kimi_Moonshot 구식 고물 같은 기계로 오늘날 가장 첨단인 3D 코드를 구동하는 이 반전 자체가 바로 월지암면이 전하려는 메시지였다. 그로부터 십여 시간 후, 10월 24일 자정을 막 넘긴 시점에 프로그래머의 날을 맞아 Kimi K3.1 Pro가 정식으로 출시되었고, 동시에 속도가 2~3배 빨라진 Highspeed 버전도 함께 선보였다. 공식은 전체 모델 가중치를 11월 4일까지 공개하겠다고 약속했다. 지난 세대 K3가 발표된 지 벌써 석 달이 넘었다. 이 석 달 동안 월지암면이 겪은 일들은 대부분의 기업이 한 해 동안 겪는 것보다도 많았다. 01 「양 늘리고 가격은 올리지 않는」 0.1 먼저 K3.1 Pro가 무엇인지부터 설명하자. 이는 완전히 새로운 모델이 아니다. 월지암면은 명확히 밝혔다. K3.1 Pro는 K3의 후훈련 버전으로, 기본 아키텍처는 그대로—총 매개변수 2조 8천억 개, 활성화 매개변수 1,040억 개의 혼합 전문가 아키텍처, 문맥 창 크기 100만 토큰, 이미지와 비디오 입력을 원래부터 지원한다는 점도 변함없다. 달라진 것은 후훈련 부분이다. 공식에 따르면, “후훈련 연산력을 대폭 증강”했으며 수백 개의 하위 분야에서 대규모 연합 강화학습을 수행했다. 이를 위해 강화학습 프레임워크, 샌드박스 인프라, 장문맥 추론 등 기반 엔지니어링 전반을 한 번에 재구성했다. 다시 말해, 같은 두뇌를 다시 한 번 어떻게 일을 처리해야 하는지 ‘재교육’한 셈이다. 그 효과는 각종 순위표에서도 드러난다. 프로그래밍 지능 에이전트를 평가하는 Terminal-Bench 4.0에서 K3.1 Pro는 65.7%를 기록해 GPT-6 Astra의 58.2%와 Claude Opus의 66.4%를 각각 앞서며 불과 1포인트 차로 경쟁 상대들을 제쳤다. 지난 세대 K3는

진행 상황 및 관련 보도

DirCast: 단일 스트리밍 비디오 언어 모델을 활용한 실시간 e스포츠 연출 및 해설

arXiv:2610.31734v1 발표 유형: 신규 초록: 실시간 e스포츠 중계에서는 매초마다 다음 장면을 예측하지 못한 채, 어떤 카메라를 송출할지 결정하는 디렉터와 그 선택에 대해 해설하는 캐스터가 필요합니다. 기존의 스트리밍 비디오 언어 모델은 이미 인간 디렉터가 제작한 방송에 대해서만 해설하는 능력을 학습해 왔습니다. 우리는 이러한 상황에서, 모든 선수의 원시 카메라 영상을 입력으로 받아, 과거 정보만을 바탕으로 동시에 연출과 해설을 수행해야 하는 실시간 방송 제작 환경을 연구합니다. 이에 따라, 두 가지 역할을 모두 수행하는 단일 스트리밍 비디오 언어 모델인 DirCast를 제안합니다. DirCast는 매초마다 모든 카메라 영상을 저해상도로 스캔하고, 유지 또는 전환 여부를 결정하는 디렉터 모드를 통해 언제 어디서 컷을 할지 판단한 뒤, 선택된 카메라 영상을 고해상도로 읽어들여 해설을 시작합니다. 또한, 모델의 문맥은 현재 송출된 내용과

DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
진행 상황 및 관련 보도

SyncVid: 동기화된 비디오 생성을 위한 세계-불변 디퓨전

arXiv:2610.31765v1 발표 유형: 신규 초록: 단일 참조 비디오로부터 동적 장면의 여러 비디오를 생성하려면, 서로 다른 시점 간에 관찰된 내용과 미관찰된 내용을 일관되게 합성해야 합니다. 기존의 비디오 디퓨전을 위한 카메라 제어 방법들은 일반적으로 카메라 임베딩, 시각 간 주의 메커니즘, 기하학적 조건부 등 다양한 아키텍처적 기법에 의존합니다. 이러한 접근법은 정적인 장면의 콘텐츠에는 효과적이지만, 시점 간 및 시간에 걸쳐 일관성을 유지해야 하는 세밀하고 동적인 기하학적 특성에는 종종 어려움을 겪습니다. 우리는 각 2D 이미지 평면에서 독립적으로 샘플링하는 대신, 소스 비디오로부터 도출된 표준적인 3D 공간에서 가우시안 노이즈 사전 분포를 샘플링하고 이를 타겟 카메라로 래스터화함으로써 디퓨전 과정 자체를 동기화합니다. 우리의 m

SyncVid: World-Equivariant Diffusion for Synchronized Video Generation
진행 상황 및 관련 보도

OpenHome: 스마트홈 카메라 영상에서 인식부터 통찰까지

arXiv:2610.31986v1 발표 유형: 신규 초록: 비전 언어 모델(VLM)은 녹화된 영상을 해석하고 유의미한 통찰을 제공하기 위해 소비자용 스마트홈 카메라 시스템에 점점 더 널리 도입되고 있습니다. 그러나 스마트홈 카메라가 캡처하는 영상 클립은 기존 VLM 벤치마크를 지배하는 큐레이션된 웹 영상과는 다릅니다. 스마트홈 영상 클립은 자막이나 내레이션이 없고, 다양한 시야각에서, 여러 조명 조건 하에, 그리고 다양한 상황에서 촬영되는 경우가 많습니다. 그럼에도 불구하고, 이 분야에서 희박한 시각적 신호와 제한된 맥락 속에서 모델이 발휘하는 성능은 기존 VLM 벤치마크로는 충분히 평가되지 못했습니다. 이러한 격차를 해소하기 위해, 우리는 스마트홈 영상 이해력을 평가하기 위한 시각 전용 4지선다형 벤치마크인 OpenHome을 소개합니다. I

진행 상황 및 관련 보도

연구는 BabyView 데이터셋을 활용하여 아동의 상황 간 어휘 의미 학습 메커니즘을 검증합니다.

이 논문(arXiv:2610.31842v1)은 2026년 10월 26일에 발표되었으며, BabyView 코퍼스—48명의 아동이 참여한 총 2,441시간 분량의 종단적 1인칭 시점 영상 데이터를 포함—를 기반으로 대비형 비전-언어 모델을 학습하여, ‘상황 간 학습’ 가설이 실제 아동의 경험에서 얼마나 실현 가능한지 검증하였다.

新闻源配图 · arXiv cs.CL

추천 이유:이 연구는 대규모 자연주의 발달 데이터를 바탕으로 상황 간 어휘 의미 학습을 체계적으로 평가한 최초의 사례로, 사전 훈련된 시각적 표현의 핵심적 역할과 학습 신호의 희소성, 그리고 모델과 아동의 학습 경로 간의 본질적 차이를 규명함으로써, 발달 인지 모델링 및 AI 언어 습득 연구에 방법론적 함의를 제시한다.

진행 상황 및 관련 보도

AudioLift: 멀티뷰 비디오 생성을 통한 오디오 기반 단일 이미지에서 풀헤드 가우시안 아바타로의 변환

arXiv:2610.31747v1 발표 유형: 신규 초록: 기존의 3D 말하는 아바타 방법들은 주로 3DMM이나 FLAME와 같은 파라메트릭 얼굴 모델에 의존하며, 이들 모델의 컴팩트한 움직임 표현 방식은 극단적인 표정을 합성하거나 헤드웨어와 같은 액세서리를 모델링하는 데 한계가 있습니다. 우리는 파라메트릭 얼굴 모델이나 개별 인스턴스 최적화 없이, 생성된 멀티뷰 비디오를 오디오 기반 아바타 생성을 위한 중간 표현으로 활용하는 두 단계 프레임워크인 AudioLift를 제안합니다. 본 프레임워크는 동기화된 멀티뷰 비디오 생성 단계와 불일치에 강한 가우시안 재구성 단계를 결합하여, 단일 인물 사진 이미지로부터 일관된 풀헤드 지오메트리를 복원합니다. 광범위한 실험 결과, AudioLift는 더 많은 표현을 포착할 수 있는 3D 말하는 아바타를 생성함을 보여줍니다.

AudioLift: Audio-Driven Single Image to Full-Head Gaussian Avatar via Multi-view Video Generation
진행 상황 및 관련 보도

Kimi, K3.1 Pro 출시: 엔드포인트 작업 능력이 최고 수준으로 도약했으며, 시뮬레이션 디버깅과 다중 모달 프로그래밍을 통해 몸을 가진 지능의 초기 모습을 보여줍니다

Kimi는 2026년 10월 25일 K3.1 Pro 모델을 출시했으며, Terminal-Bench 4.0 터미널 작업 테스트에서 67.2%의 성공률로 1위를 차지했습니다. 또한 자체적으로 에뮬레이터 오류를 복구하고 물리 시뮬레이션, 오디오 분석, 3D 장면 구축 및 영상 편집 등 다중 작업을 수행하는 능력을 갖추고 있어, 신체 기반 지능 기술의 발전 경로를 탐구하고 있음을 보여줍니다.

根据报道中的虚拟人行走训练和模拟器调试制作的编辑示意,非软件实拍截图

추천 이유:본 자료는 티미디어의 공식 라이선스를 받아 발표된 실측 보고서를 기반으로 하며, Artificial Analysis, Terminal-Bench 4.0 등 권위 있는 제3자 평가 데이터와 공식 자체 테스트 결과, 그리고 필자의 다중 시나리오 기능 검증을 포괄합니다. 특히 K3.1 Pro의 실행 성능, 시뮬레이션 클로즈드 루프, 다중 모달 프로그래밍 분야에서의 실질적 진전에 초점을 맞추고 있으며, 동시에 Flash/Ultra가 아직 출시되지 않았다는 점 등 성능상의 한계와 미공개 정보를 명확히 표기하여 사실 확인과 출처 표기 요건을 준수하고 있습니다.

진행 상황 및 관련 보도

세바스티안 라슈카가 8개의 비디오 강좌 ‘제로부터 추론 모델 구축하기’를 발표했습니다.

세바스티안 라슈카는 2026년 10월 24일, Ahead of AI 매거진(magazine.sebastianraschka.com)에서 총 8강으로 구성된 11시간이 넘는 파이썬 및 파이토치 실습 동영상 강좌를 공개했으며, 추론 모델의 평가, 추론 시 확장, 강화학습(RLVR)과 지식 증류를 체계적으로 다루고, 모든 방법을 사전 훈련된 Qwen3-0.6B 모델을 기반으로 구현했습니다.

추천 이유:이 강좌는 저자가 ‘0부터 구축하는 대규모 언어 모델’에 이어 선보이는 심화 기술 교육 콘텐츠로, 현재 주류 LLM의 핵심 발전 방향인 추론 능력 강화에 초점을 맞추고 있습니다. 기초 환경 구축부터 GRPO 강화학습, 자기 증류 등까지 포괄하는 완전한 기술 체인을 다루며, 모든 구현은 ‘0부터 수작업으로 작성’되어 재현 가능하다는 점을 명시하고 있어 높은 교육적 가치와 엔지니어링 참고 가치를 갖습니다.

진행 상황 및 관련 보도

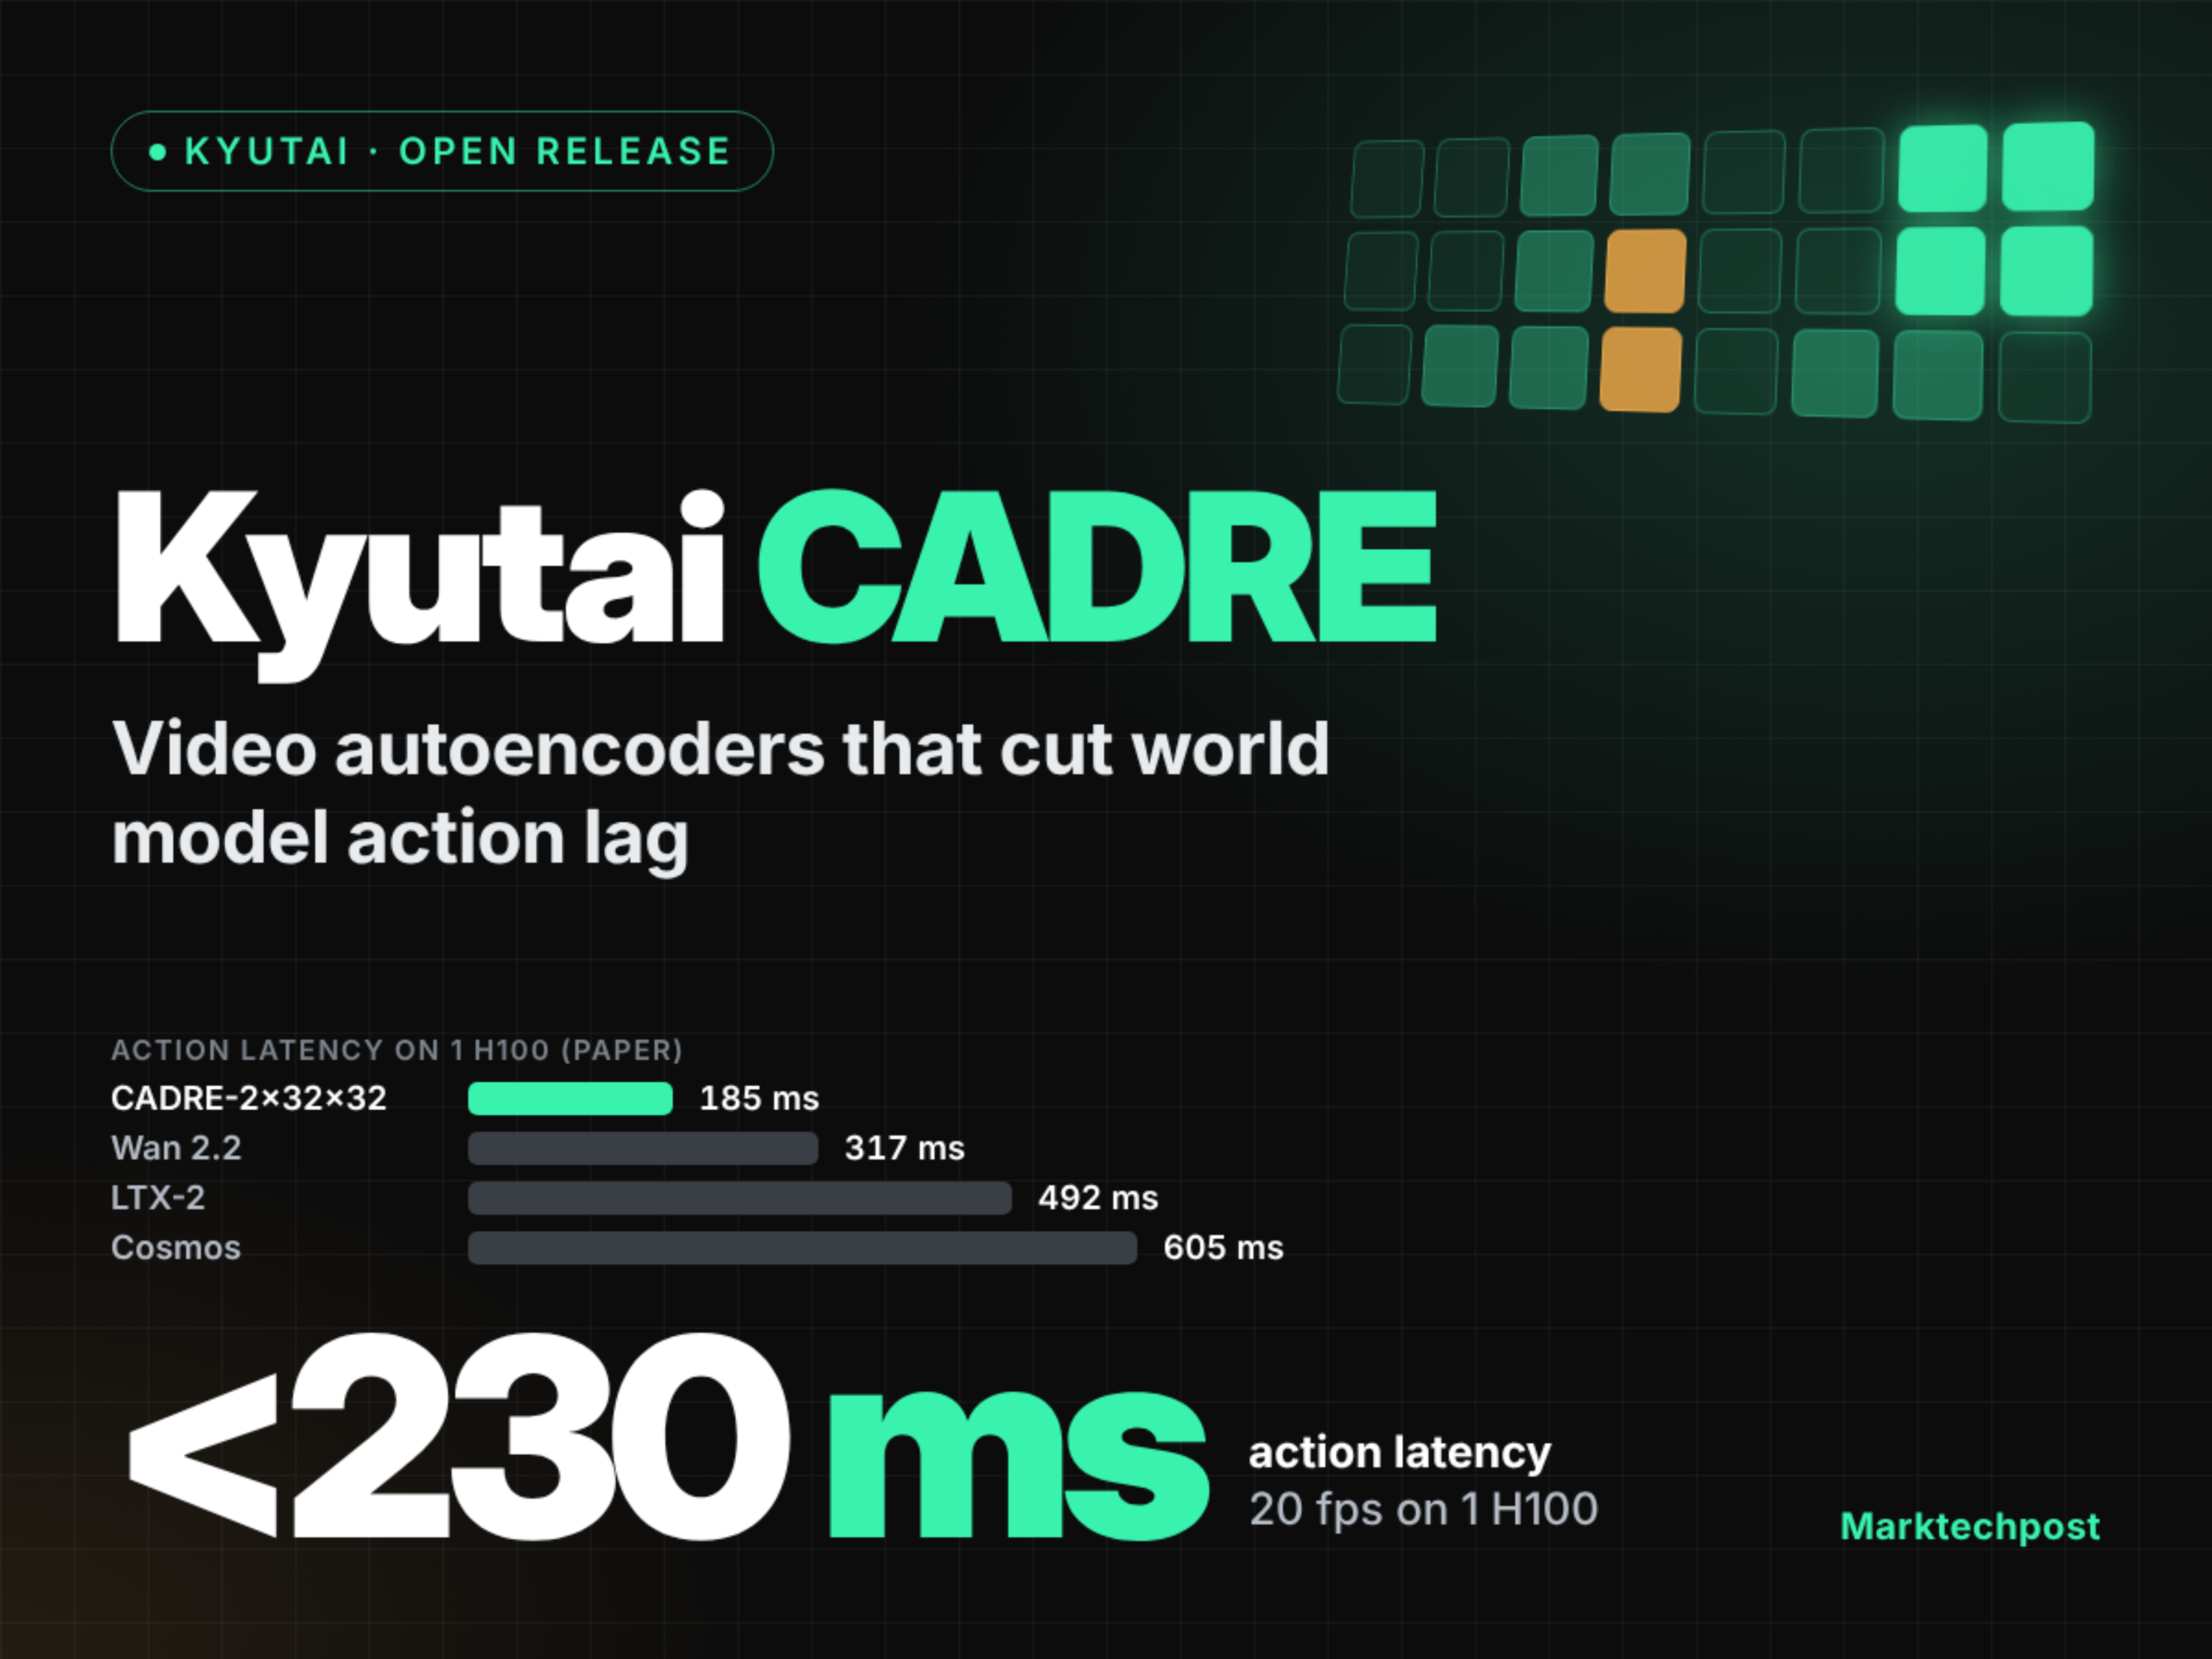
Kyutai는 CADRE 비디오 자동부호화기 계열을 출시했습니다: 대화형 세계 모델을 지향하며, 엔드투엔드 동작 지연 시간을 230밀리초 이하로 낮췄습니다.

Kyutai는 2026년 10월 23일, 세계 모델의 동작 지연을 줄이도록 설계된 7개의 오픈소스 인과 확산형 비디오 자동부호화기로 구성된 모델 패밀리인 CADRE를 공개했다. 단일 H100 GPU에서 측정한 반응 지연은 최저 185ms에 달하며, 추론 속도는 23.4fps에 이르고, 시나리오 FVD 지표는 162.6으로 낮아졌다(와니 2.2의 경우 599.7). 다만 로봇 작업 과제에서는 동작 추종률(ARR)이 와니 2.2 및 코스모스에 비해 다소 떨어진다.

Kyutai CADRE: Video Autoencoders That Cut World Model Lag Below 230 ms
진행 상황 및 관련 보도

엔비디아 CEO가 마이크로덕 로봇의 사전 판매 돌풍을 시연하며, 주문 수량이 2만 대를 넘어섰다.

GTC 베를린 컨퍼런스에서 엔비디아의 CEO 젠슨 황은 폴렌 로보틱스가 개발하고 현재 허깅 페이스(엔비디아에 인수됨) 소속인 마이크로덕 로봇을 시연했습니다. 이 오픈소스 로봇은 음성 명령을 통해 보행, 앉기, 가만히 누워 있기, 뒤로 공중제비 등의 동작을 수행할 수 있습니다. 해당 영상이 온라인에서 큰 화제를 모은 뒤, 다음 날 사전 예약 판매량이 2만 대를 돌파해 크리스마스 시즌의 인기 장난감으로 자리매김할 것으로 기대됩니다. 이들 로봇은 엔비디아의 기술 스택을 기반으로 학습되었으며, 사용자가 자체적으로 학습을 진행하고 새로운 기술을 공유할 수 있도록 지원합니다.

추천 이유:정보는 제공된 TechCrunch 기사와 사실 목록을 바탕으로 생성되었습니다. 자료에 따르면 Microduck은 Pollen Robotics에서 제작되었으며, 이 회사는 2025년에 Hugging Face에 인수되었고, 엔비디아는 같은 해 9월에 Hugging Face를 인수했습니다. 본문에서 언급된 사전 판매 데이터, 기능 설명 및 배송 일정은 모두 자료에서 직접 인용한 것으로, 외부 정보는 추가되지 않았습니다.

진행 상황 및 관련 보도

데 스타트 - 프리덤 (공식 뮤직비디오)

데 스타트 - 프리덤 (공식 뮤직비디오) 자, 이건 저에게는 처음이네요... 네덜란드의 얼터너티브 록 밴드 데 스타트의 이 새로운 뮤직비디오에서 00:44초 지점에 보면, 시각 효과는 Fake it or Leave it의 매티스 그루텐에게 공로가 있습니다. 해커 뉴스의 flir을 통해 태그: 음악, AI, 생성형 AI, 자전거를 타는 펠리컨

진행 상황 및 관련 보도

스위치 2가 구형 게임과 AI를 이용해 탈옥에 성공했으며, 모더가 ‘마리오 카트 월드’의 맞춤형 캐릭터를 선보였다.

The Verge에 따르면, 유명한 모더인 Sammy Hajhamid(온라인 닉네임 pepsipu)는 닌텐도 스위치 2를 성공적으로 탈옥했다고 밝혔으며, 그의 도구 ‘ns2jb’는 OpenAI Codex의 지원을 받아 개발되었고, 한 오래된 게임을 통해 취약점을 유발했다고 한다. 시연 영상에서는 ‘마리오 카트 월드’가 시나모롤, 빨간색 분노의 새, 피터 그리핀, 마인크래프트 스티브 등 비공식 캐릭터가 포함된 수정 버전으로 실행되는 모습이 보여졌다.

진행 상황 및 관련 보도

파나슈 — 모바일용 벨 에포크 RTS

파나슈 — 모바일용 벨 에포크 RTS 참으로 기분 좋은 일이네요: 저는 어제 Apache 2.0 라이선스 하에 ‘배틀 드론스’를 출시했는데, 이미 프랑스어 버전 포크가 나와서 게임의 배경을 스팀펑크풍의 1900년대 프랑스로 바꾸고 애니메이션 인트로까지 추가했습니다! 파나슈는 모바일과 웹브라우저에서 즐길 수 있는 벨 에포크 시대(약 1900년경)의 프랑스를 배경으로 한 실시간 전략 게임입니다. 비행선, 증기식 장갑차, 크뢰조 장갑함, 투구를 쓴 자동인형, 그리고 이동하는 요새 ‘가르강튀아’ 등, 화려한 볼거리가 가득합니다. 여기에서 파나슈를 플레이해 보실 수 있습니다—새로운 인트로 영상을 직접 확인해 보시려면 링크를 클릭해 보시는 것도 좋습니다. 현재까지는 게임플레이 변경보다는 주로 미적 요소 위주의 업데이트에 그치고 있습니다. 음악에도 프랑스 특유의 감성이 더해졌고요. 새로운 스팀펑크 스타일의 모델들은 정말 멋집니다! 여기에는 해당 페이지가 있습니다.

진행 상황 및 관련 보도